AI NEWS · 図解と解説
Claude CodeでAIの品質改善を回す
build-evalとhillclimbを、記事制作の「直し方」に生かす
AI NEWS 解説|2026年10月3日時点
公開: · 情報確認日とは別の公開日時です。
各社の公式手順と、本稿の制作への応用案を区別しています。AI NEWSで実施した範囲は末尾に記載しています。図をタップすると原寸画像を開けます。
AIに文章を書かせ、気になるところを直してもらう。その繰り返しで、品質は本当に上がっているのだろうか。Claude Codeの評価・改善機能を手がかりに、記事やスライドを継続して作る人が持っておきたい「良くなったと確かめる仕組み」を考える。
文章が読みやすくなっても、引用の条件が抜けていれば公開できない。説明が詳しくなった一方で、スライドと本文の数字が食い違うこともある。AIを仕事に使うほど、こうした複数の条件を同時に満たす難しさが見えてくる。
Anthropicは2026年9月28日、Claude Codeの「/claude-api build-eval」と「/claude-api hillclimb」を紹介した。前者は評価用の例題と採点方法を作り、後者はその評価を使って改善を繰り返す。公式解説
注目したいのは、依頼文を変えるたびに出来栄えを見比べる作業を、記録できる工程へ移せることだ。本稿は関連する解説動画を入口に、一次資料と評価研究を確認し、AI NEWSの制作にどう応用できるかを整理する。後半の運用例は本稿の提案である。
evalでは、仕事の出来栄えを確かめる
evalはevaluation、つまり評価の略だ。入力、望ましい結果、判定方法をそろえ、同じ条件でAIの出力を比較する。記事制作なら、ある発表資料を渡したとき、何を正しく説明し、何を断定してはいけないかを先に決める。
ソフトウェアの単体テストは、例えば「日付の形式を変換する関数が、期待した文字列を返すか」を確認する。記事の品質評価は、その上で「発表日と提供開始日を混同せず、読者がいつ使えるかを理解できるか」まで扱う。単体テストは評価を支える一部になるが、テストが通っただけで記事全体の正確さや有用性が証明されるわけではない。
Anthropicも、コード、モデル、人による採点を組み合わせる考え方を示している。研究や調査を行うエージェントでは、主張の裏付け、必要な情報の網羅、出典の質をそれぞれ見る。評価の設計に関する解説
まず測りたい仕事を小さく切り出すとよい。「良い記事を書く」では広すぎる。「新製品の発表を、利用条件と未確定事項を落とさず初心者向けに説明する」なら、失敗例も合格条件も具体化しやすい。
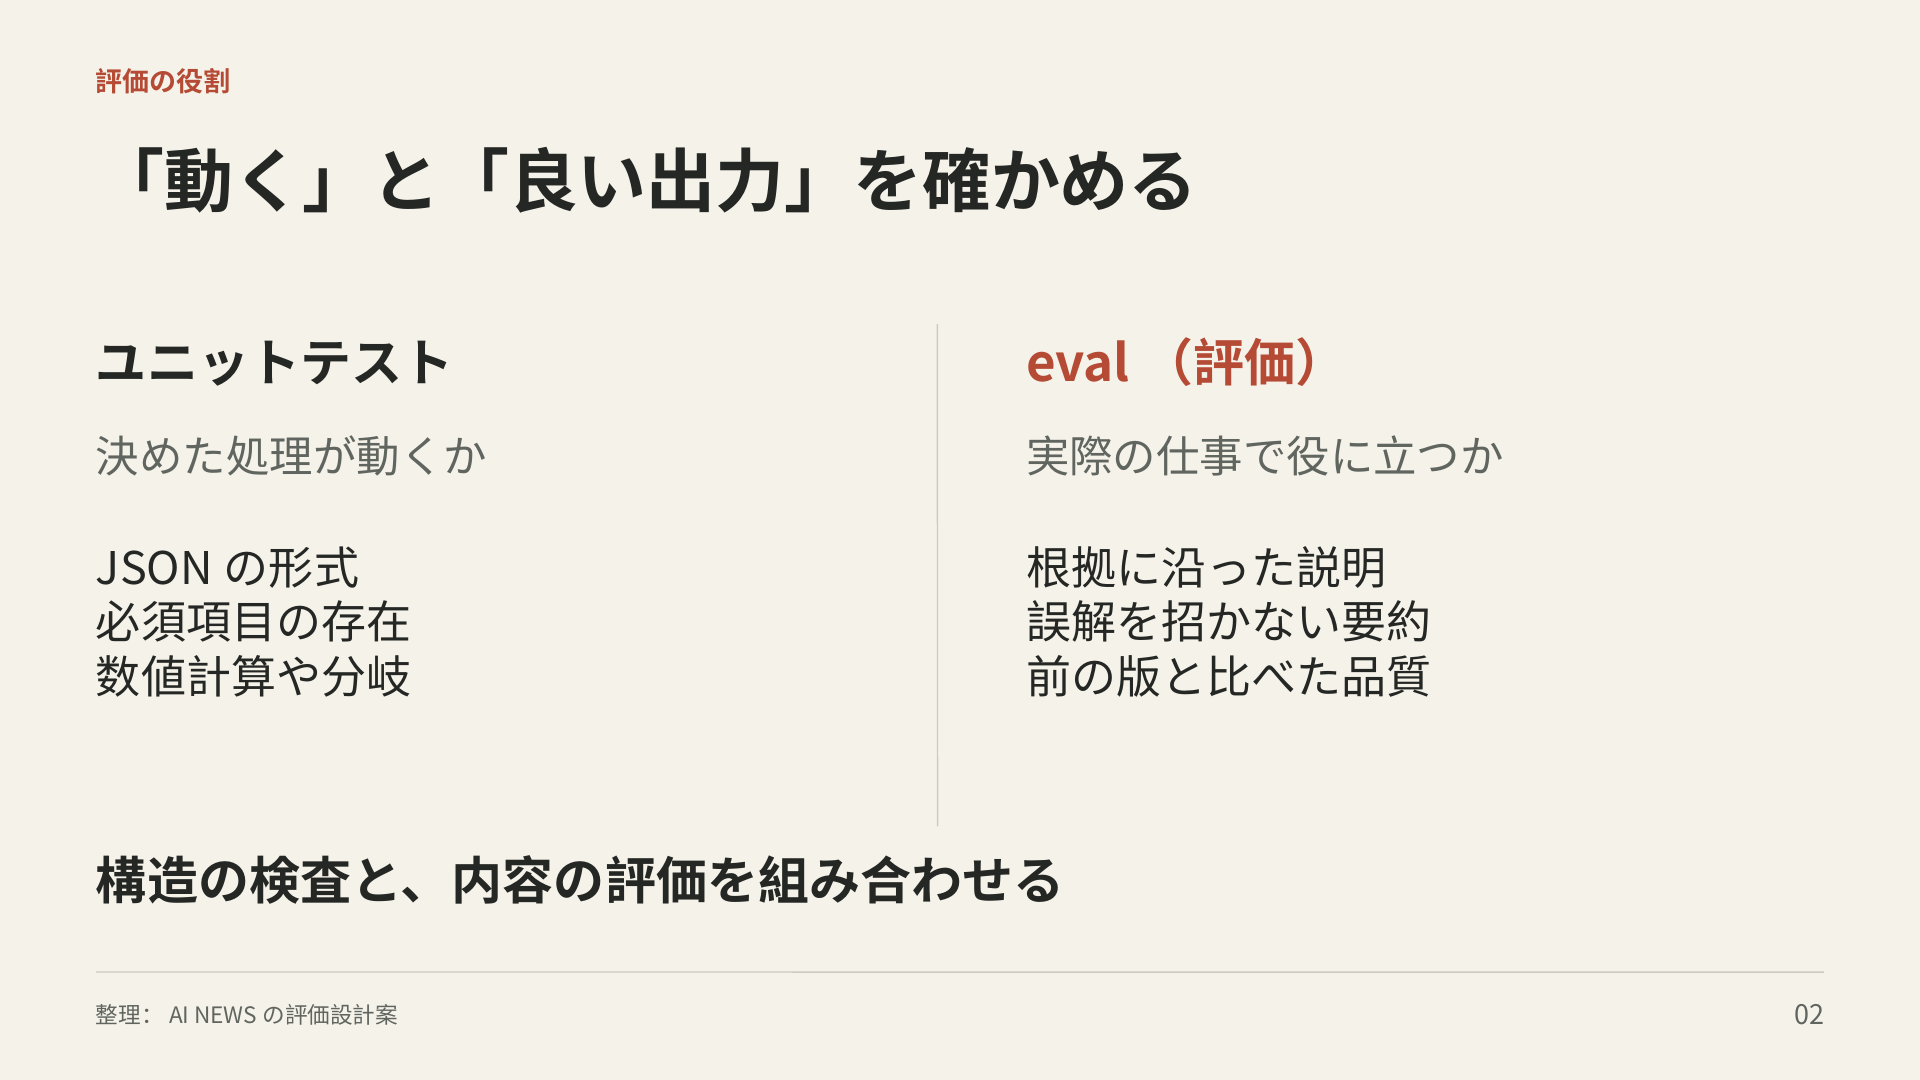
二つのコマンドが受け持つ役割
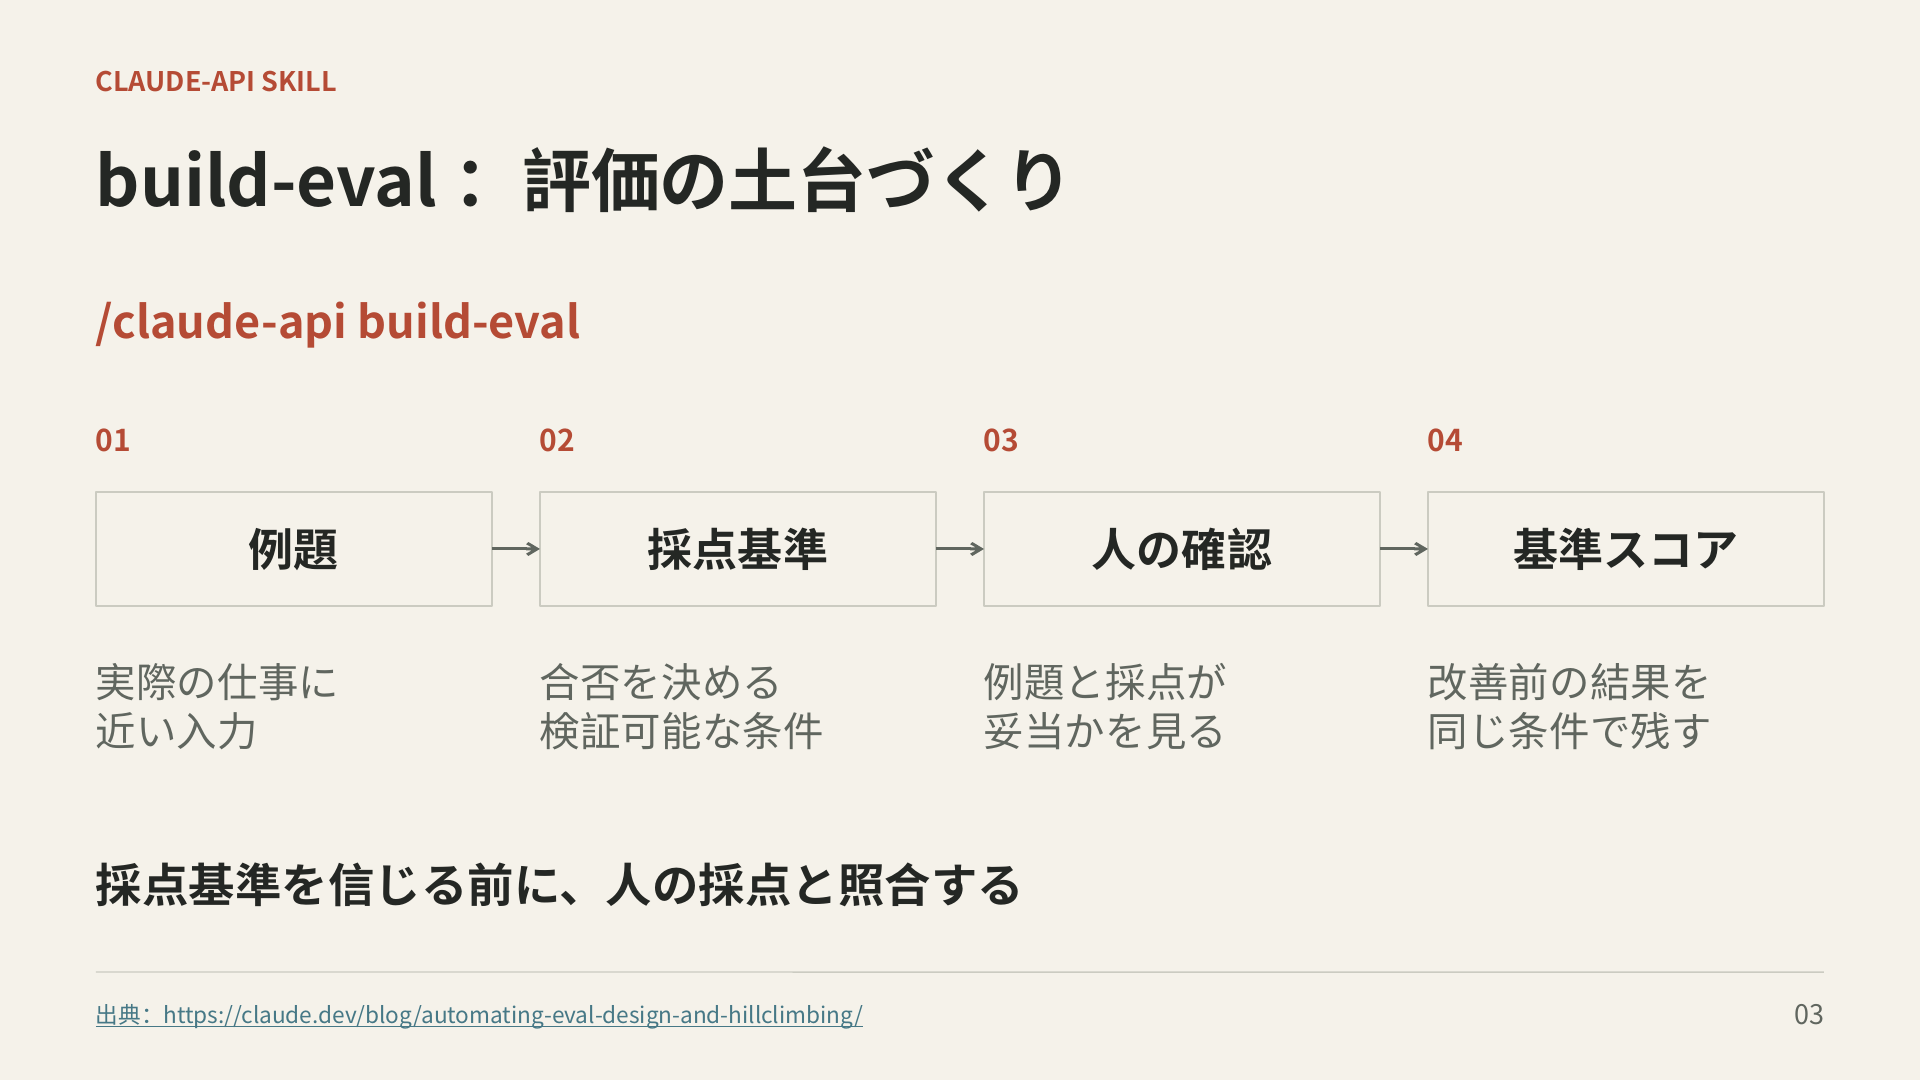
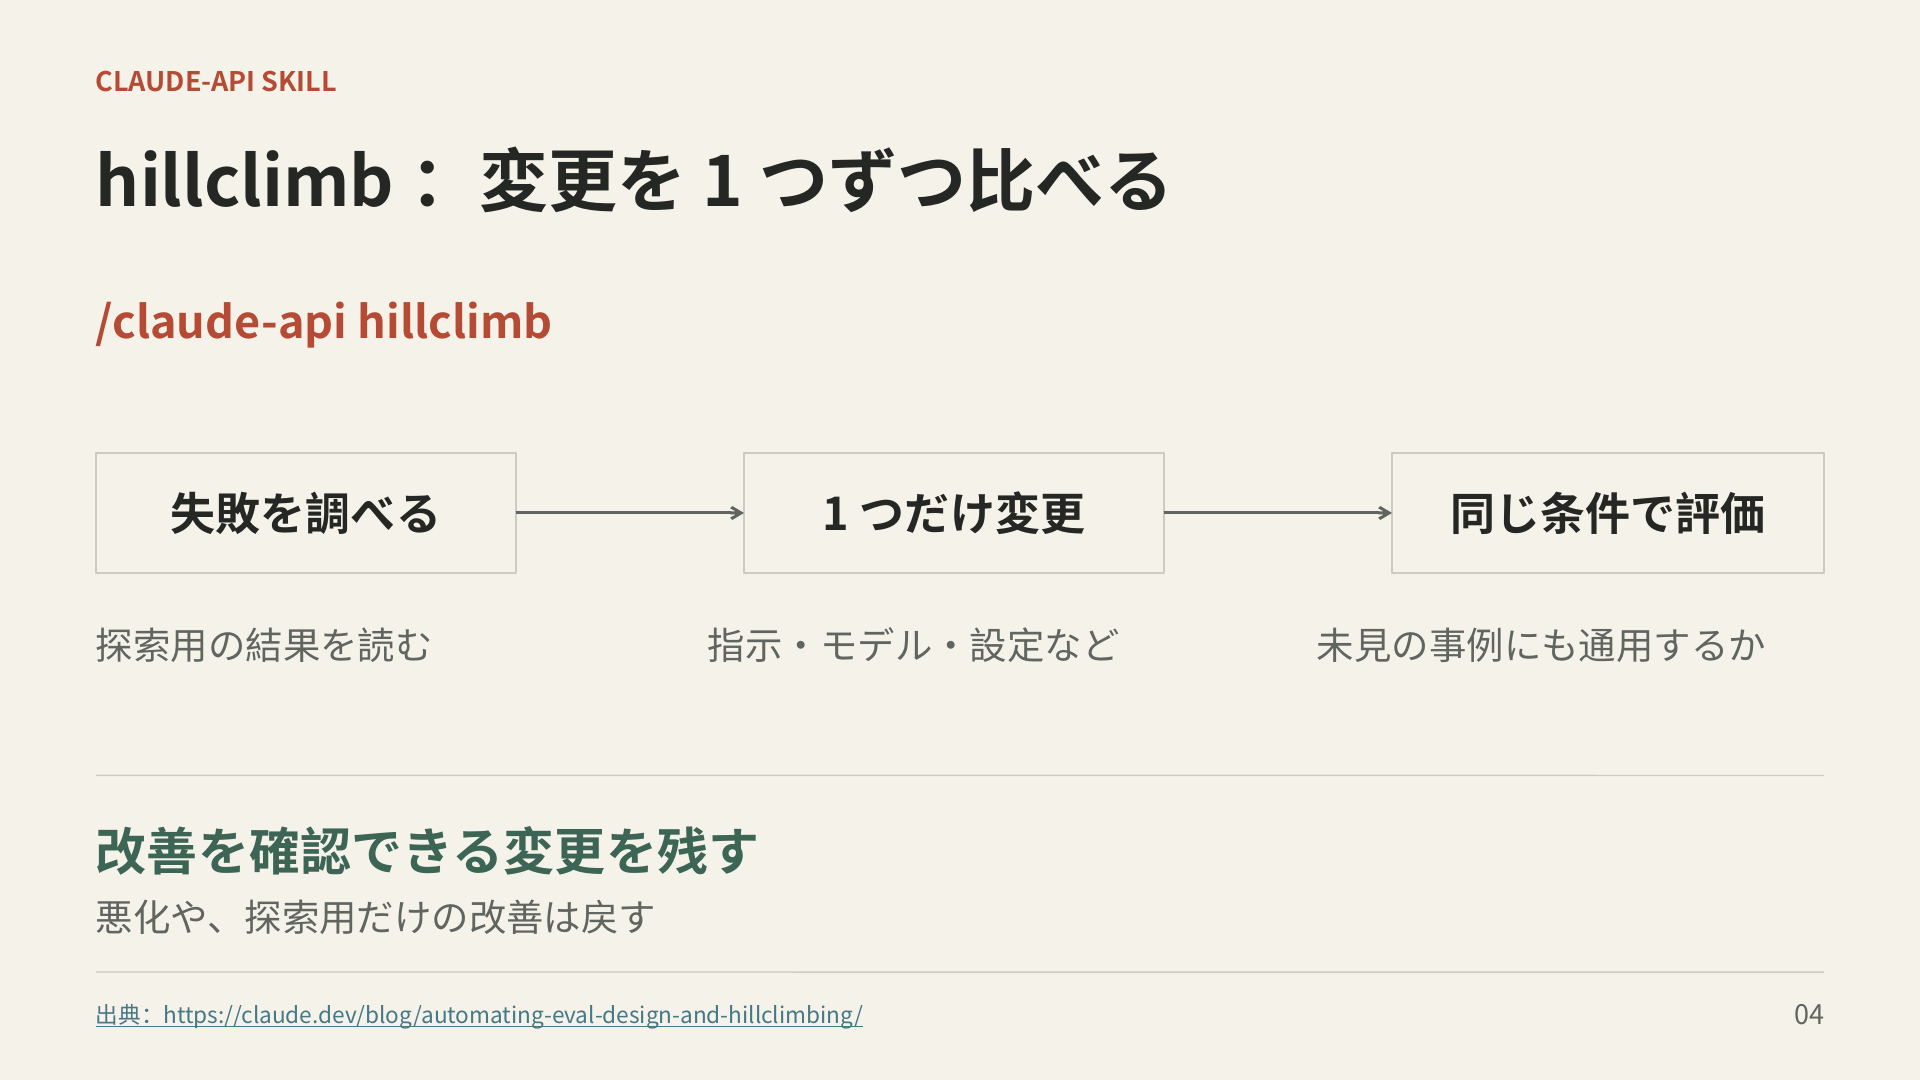
build-evalは、例題と採点の妥当性を人に確認し、改善前の基準となるベースラインを測る。hillclimbは、変更を一つずつ試し、改善用データと分けて確保したデータで比較する。改善用だけが上がる変更や悪化を戻し、測定のばらつきも点検する、という流れだ。公式の手順
記事制作に置き換えるなら、最初に原稿を採点し、失敗が「日付の混同」に集中していれば、執筆指示の該当部分を直す。その後、同じ資料で再び原稿を作り、別の題材でも改善したかを確かめる。語尾、構成、モデル、資料の渡し方を一度に変えると、どれが効いたのか分かりにくくなる。
ここでいう改善は、必ずしもAIモデル自体の再学習を意味しない。制作側が扱う指示、資料の構成、判定の手順を整えることにも大きな余地がある。出力の一箇所を手で修正するだけで終わらせず、次回も起きる原因を探すための考え方だ。
「98.9%」をそのまま実力と読まない
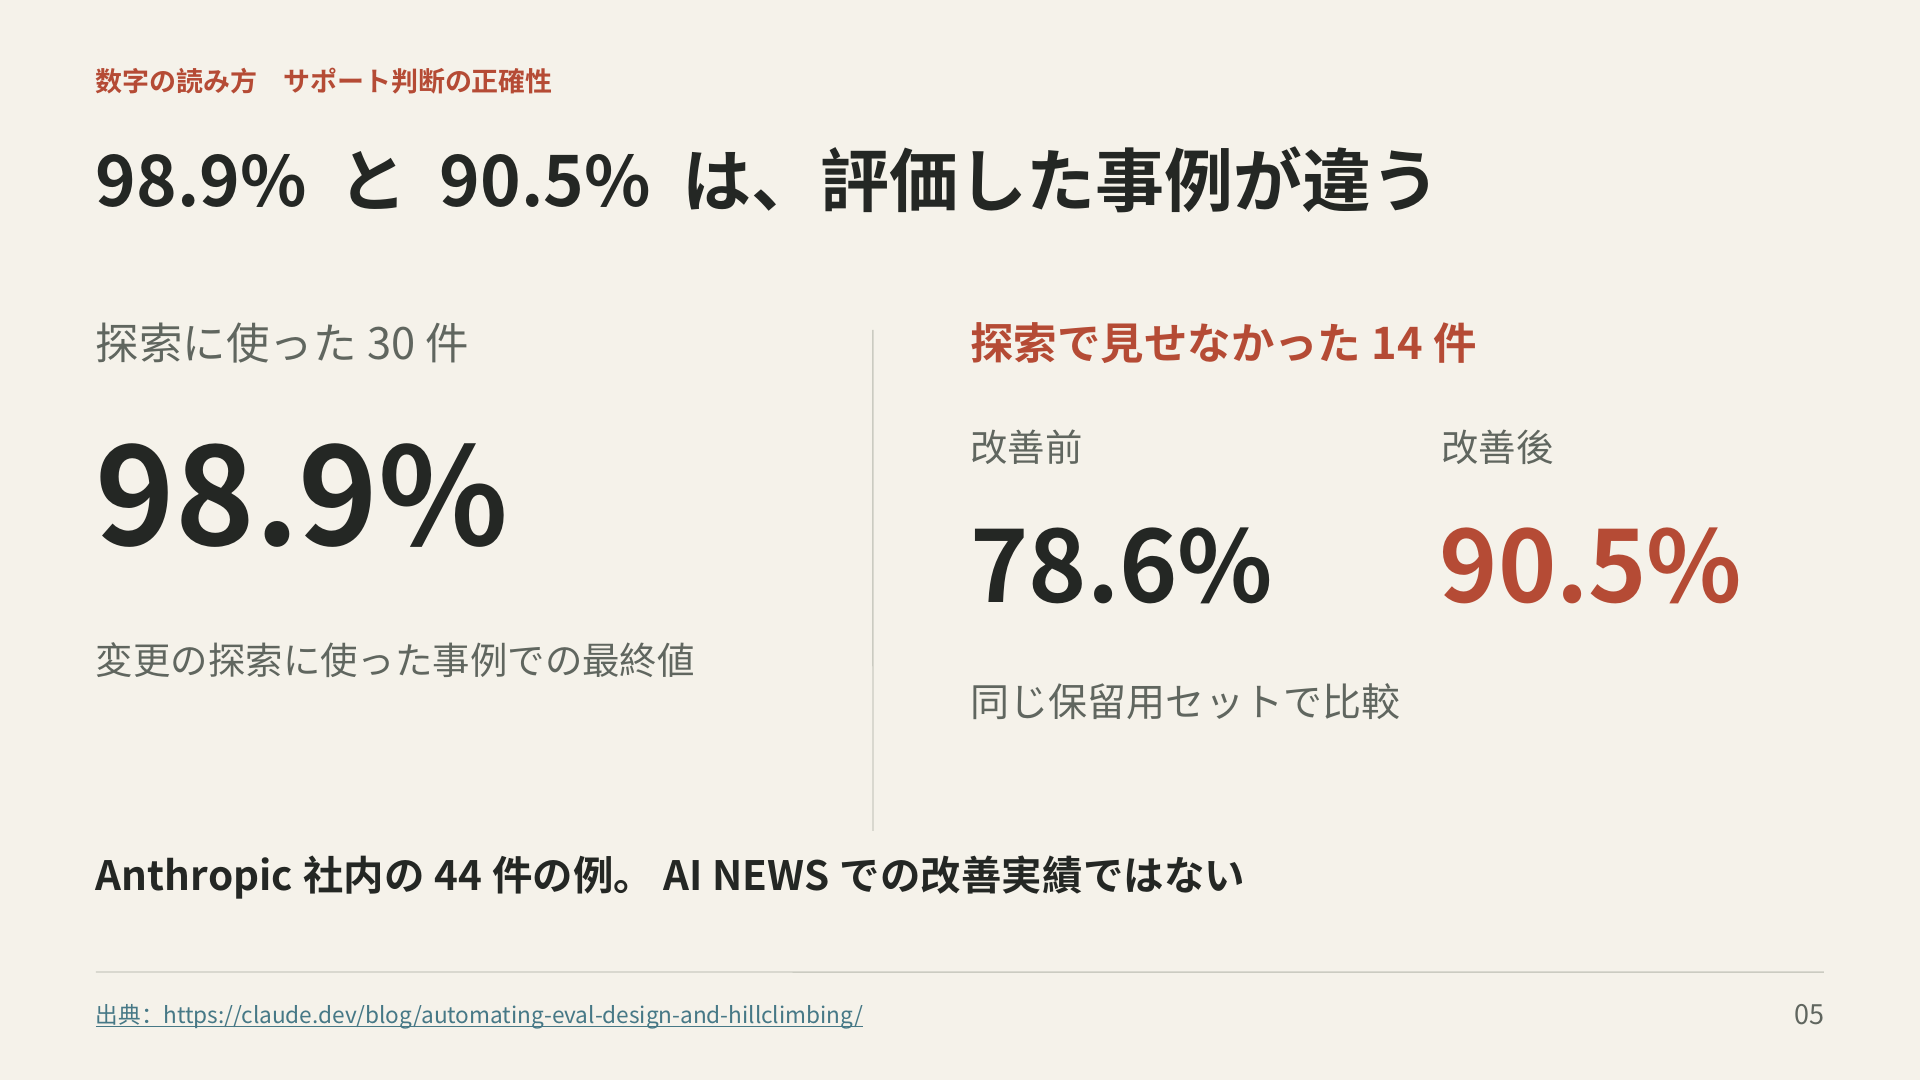
公式の顧客サポート評価では、44件を探索用30件と保留用14件に分けている。最終構成の98.9%は探索用の結果で、保留用は78.6%から90.5%へ改善した。途中のlow effort設定では、Sonnet 5が88.9%、Opus 5.5が87.8%だった。特定条件下の比較であり、モデルの一般的な順位ではない。公式の実験例
数字を記事にするなら、「何の仕事か」「どのデータか」「どの設定か」をセットで書く必要がある。小数点付きの精密な見た目だけでは、幅広い実務に通用する確かさは分からない。少数の題材を何度も試した結果と、多様な題材を一度ずつ試した結果も同じではない。
なお、公式ページのメール振り分け例にある68.1%や87.5%は、画面を説明する模式例に含まれる数値だ。実際の導入成果として扱うべきではない。該当する図の説明
AI NEWSなら、採点基準を五つに分ける
記事とスライドを一組で制作する場合、文章のうまさだけでは品質を捉えられない。以下は、公開前の確認と改善の記録に使うための設計例だ。各項目に「判定」「問題箇所」「根拠」「直す理由」を残す。
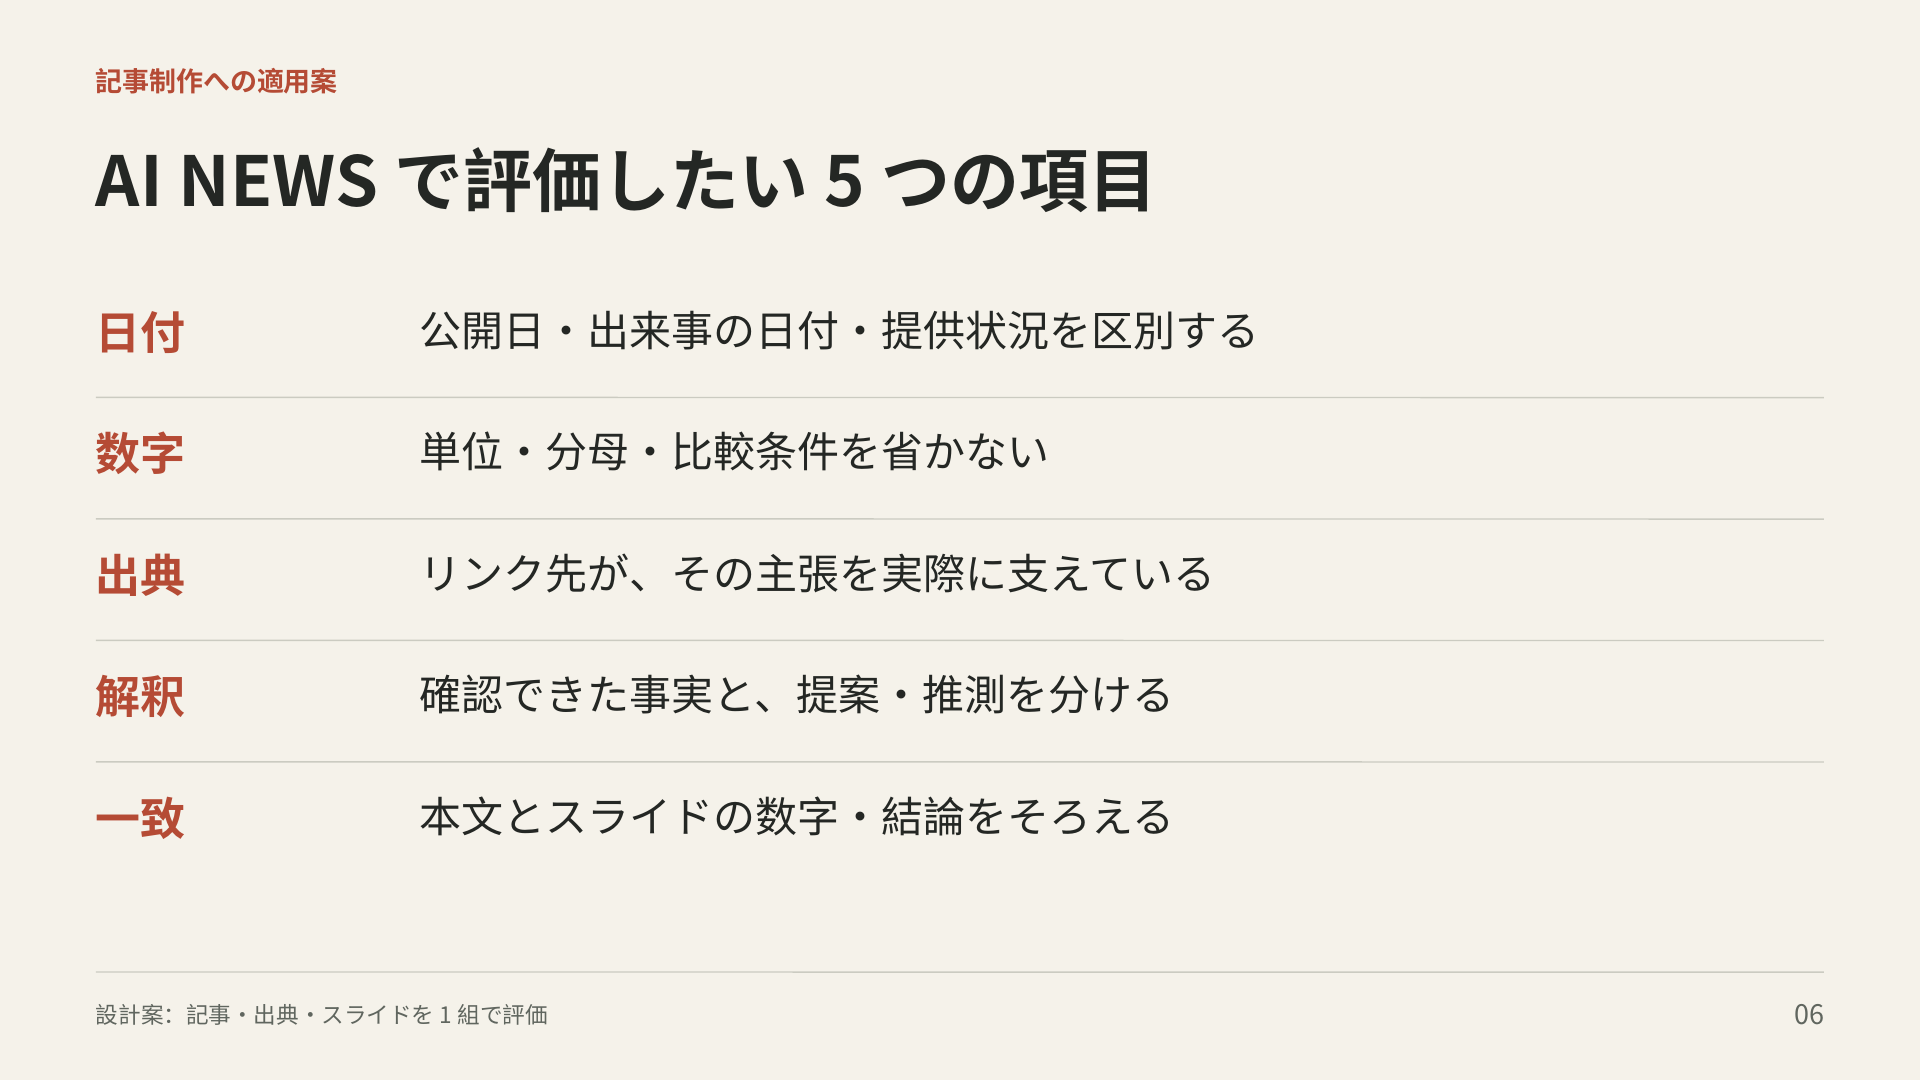
第一は、出典と主張の対応だ。「出典リンクがある」だけで合格にしない。主要な主張を抜き出し、そのリンク先のどこが裏付けなのかを確認する。資料が読めない、根拠が見当たらない場合は「未確認」にする。リンクの数を増やしても、裏付けが増えたとは限らない。
第二は、日付と提供状況だ。発表された日、一般に使える日、限定提供の開始日を分ける。「発表」を「誰でも利用可能」と書き換えていないかを確認する。情報を確かめた日も記録し、後から条件が変わった記事を探せるようにする。
第三は、数字と比較条件だ。割合の分母、対象件数、モデルや設定、比較対象をセットで管理する。正答率と誤答率、金額と削減率のように、見た目が似ていて意味が違う数字を区別する。収益や作業時間への効果も、測っていないなら見込みとして記す。
第四は、事実と解釈の区別だ。企業が発表した内容、出演者の意見、本稿の分析が誰の言葉なのか分かるようにする。「可能性がある」という見通しを、見出しで確定事項にしていないかも見る。条件を削って強く見せる編集は、本文だけ読んでも見落としやすい。
第五は、スライドと本文の整合性だ。短いスライドほど、数字の条件や対象が落ちやすい。本文の主張に番号を付け、スライドの対応箇所と結び付ければ、修正が片方だけに反映された状態を発見しやすくなる。スライドだけ読む人にも誤解が生じないかを確認したい。
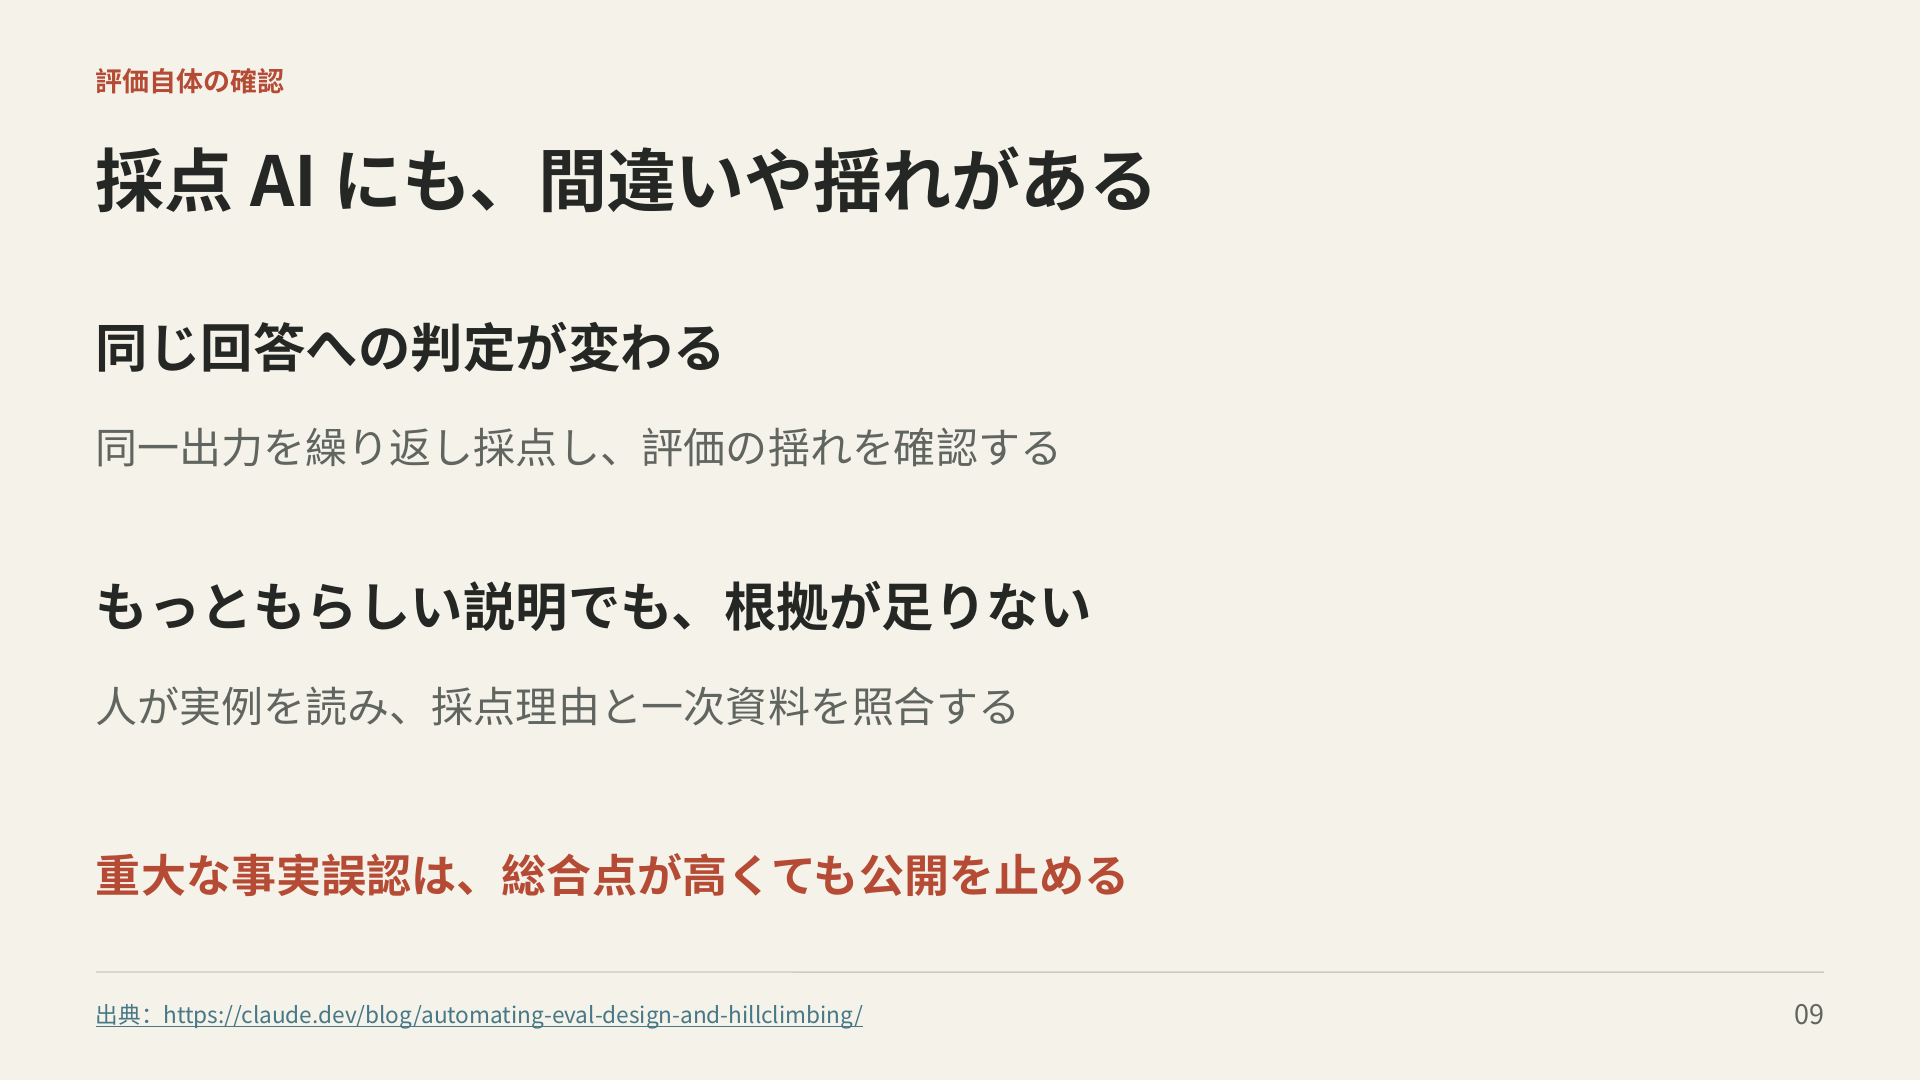
総合点を作る場合も、重大な誤りを平均で埋め合わせない。文章が読みやすくても、存在しない出典や誤った数値があれば公開を止める。重大な問題がないことを入口の条件とし、その後で読みやすさ、説明の順序、読者に役立つ具体性を比べる設計が適している。
自動で確認する部分と、人が読む部分をつなぐ
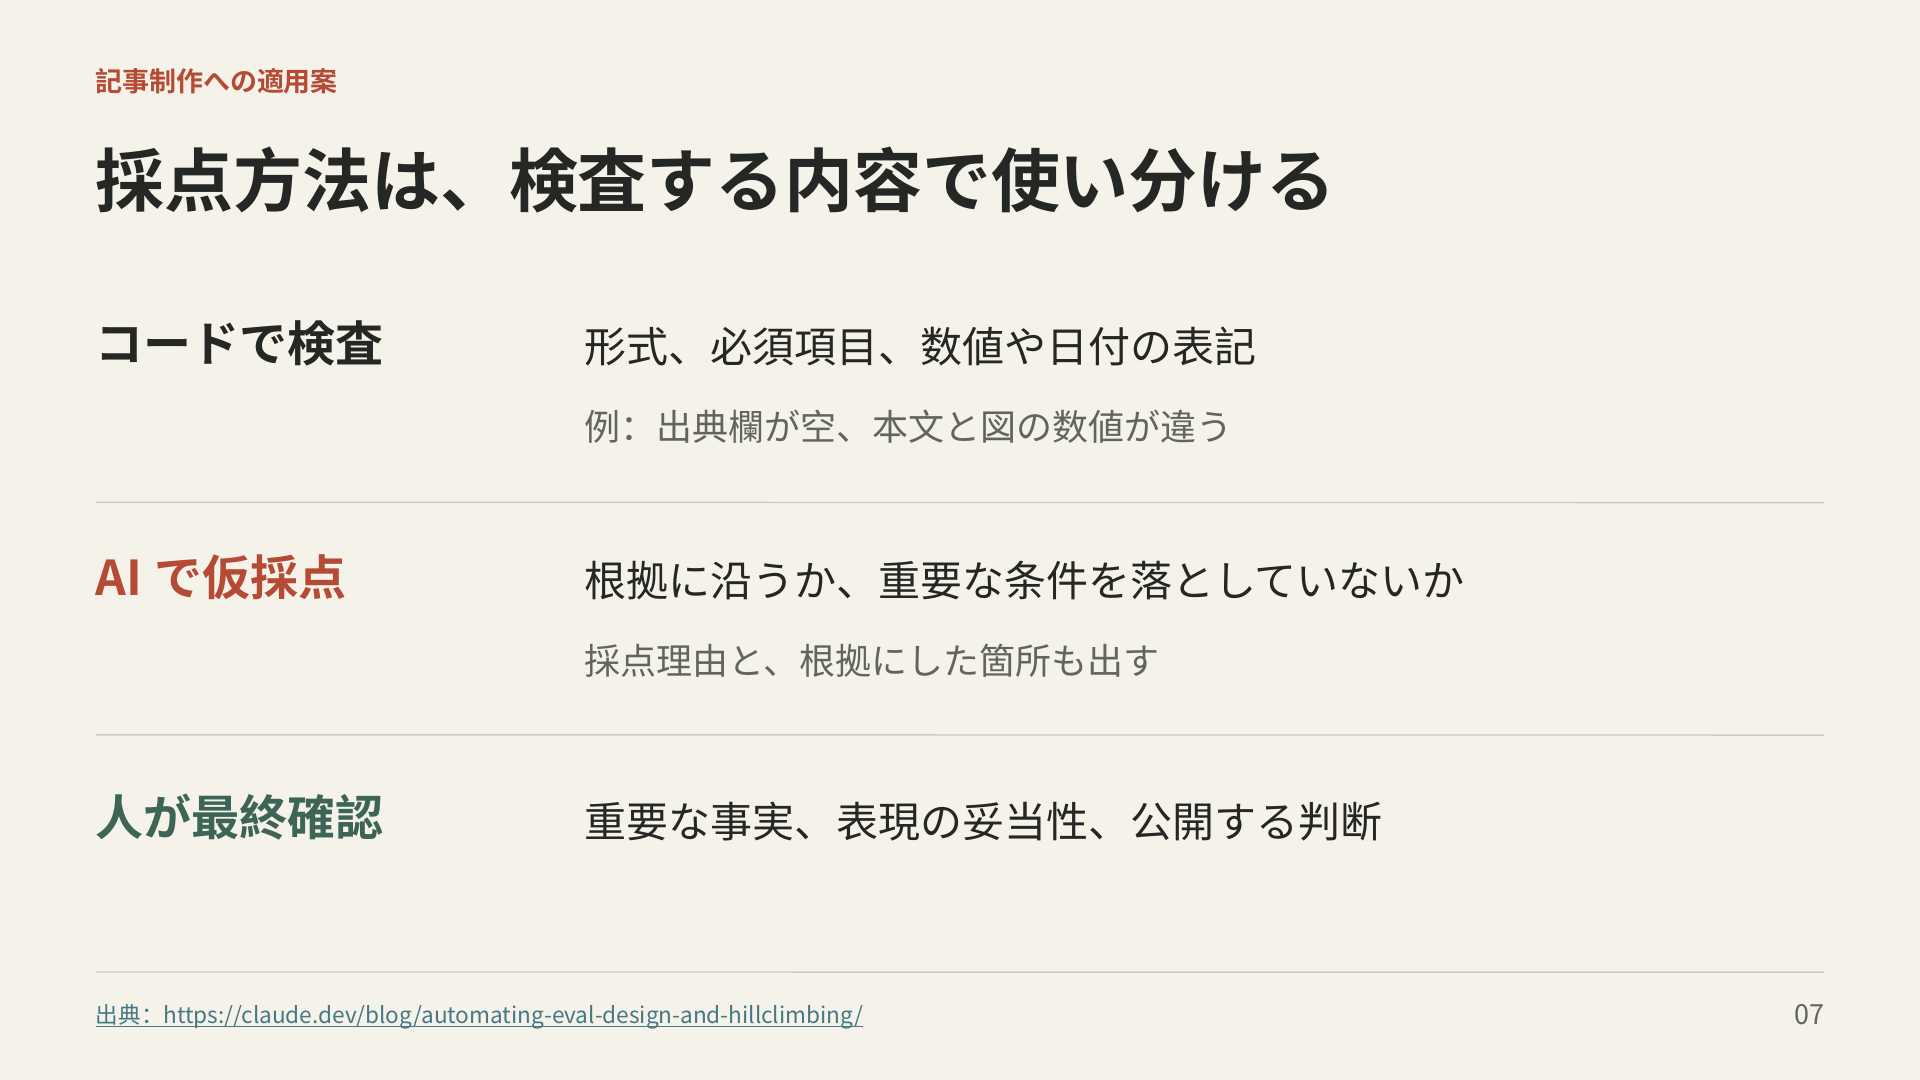
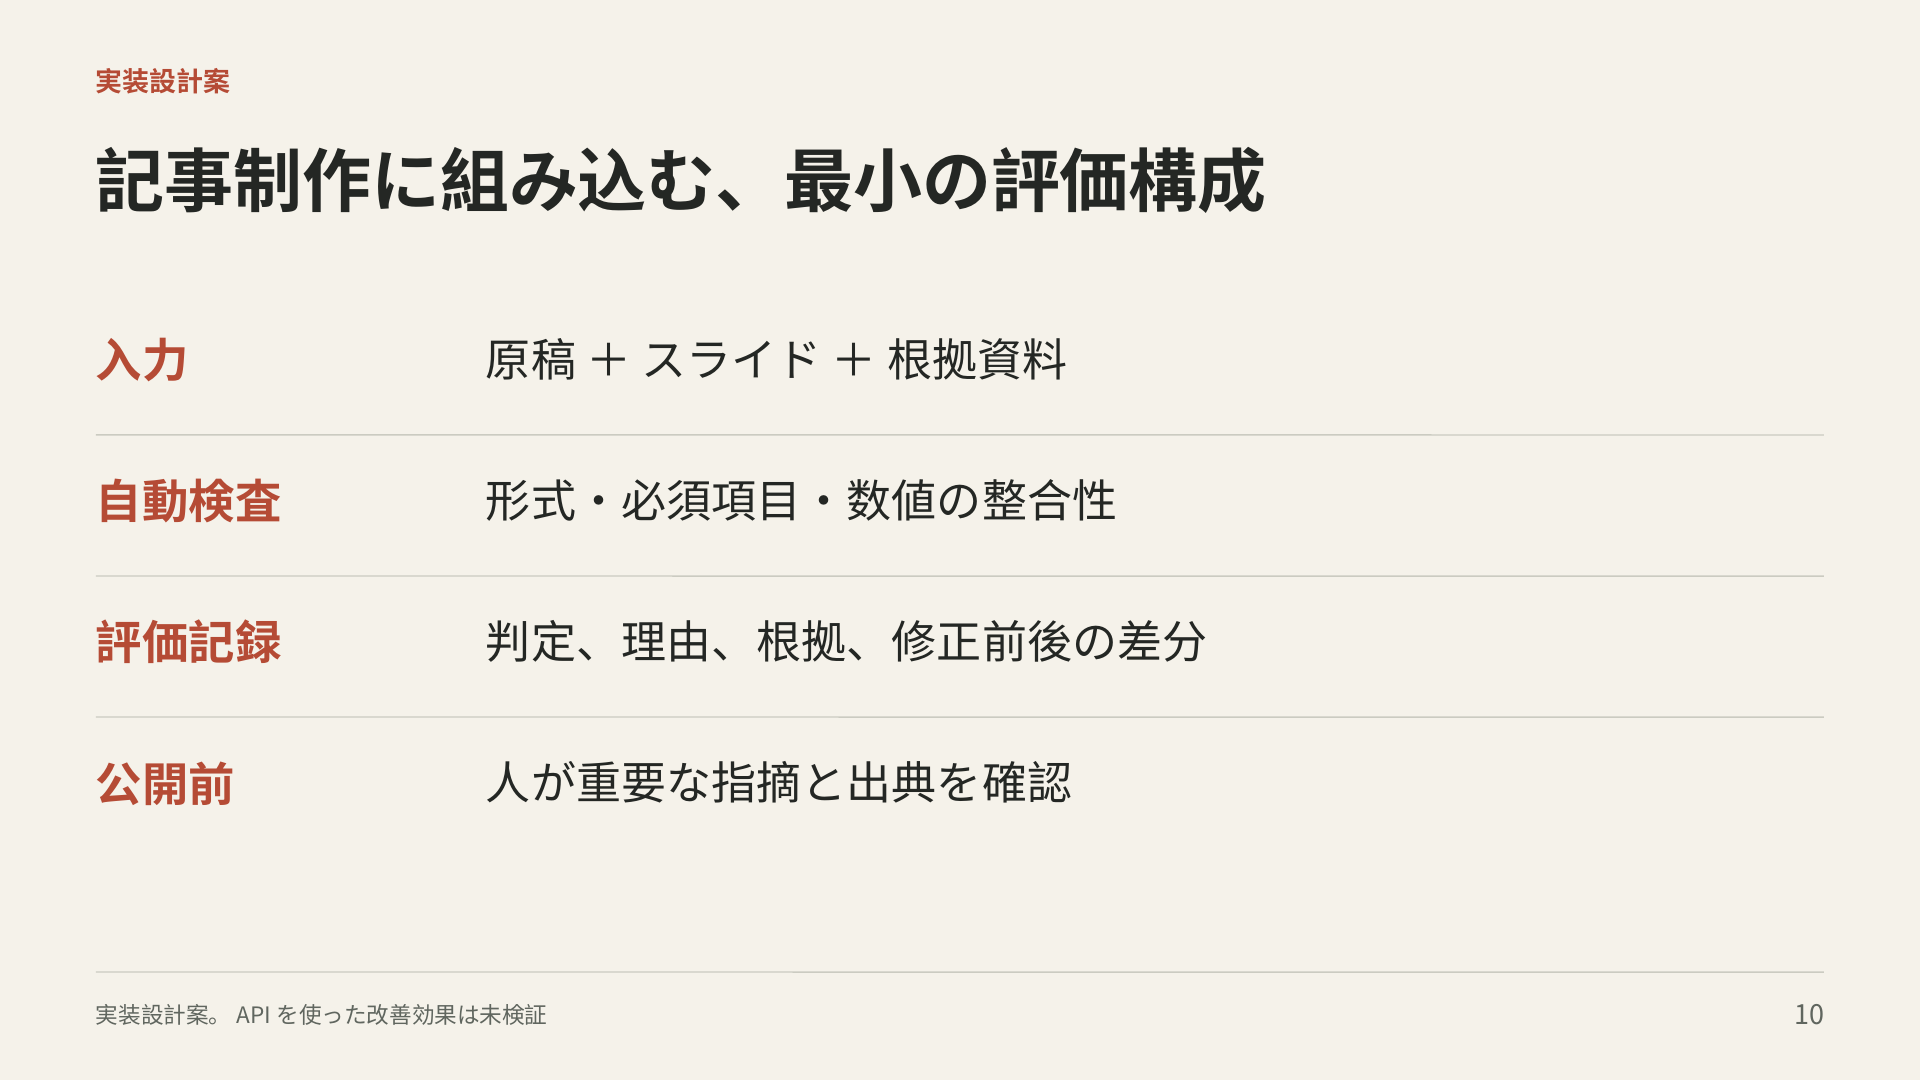
実装は二段階にすると始めやすい。第一段階は、明確なルールにできる確認だ。必須の見出しがあるか、公開日が空欄でないか、主張と出典を結ぶ番号が存在するか、といった項目をプログラムで調べる。これは速く、同じ入力なら同じ結果を得やすい。
ただし、URLがあることと、そこに根拠があることは別だ。文章中の数字を機械的に拾うだけでも、年号、型番、性能値を誤って比べる可能性がある。検出した問題をそのまま断定せず、対象となる主張と資料の抜粋を並べて確認できる形にしたい。
第二段階は、意味を読む評価だ。例えば「この段落は、資料の条件付きの主張を無条件に広げていないか」を、根拠とともに人や別のAIへ判定させる。Anthropicの評価設計資料も、明確で測定可能な基準を置き、用途に合う採点方法を選ぶことを勧めている。評価基準の公式ガイド
採点用AIを使っても、正しさが自動で確定するわけではない。LLMを評価者にする研究では、回答の順序や長さ、自身の出力への好みなどによる偏りが指摘されている。Zhengらの研究
そこで、正しい記事、もっともらしい誤りを含む記事、判断材料が足りない記事を先に用意し、人の判断と照合する。「詳しいが条件を落とした説明」が「短くても正確な説明」より高く採点されるなら、その採点基準を見直す。公開前には、重要な主張と判断が割れた箇所を人が読む工程を残す。
保留データも、使い続ければ答えに近づく
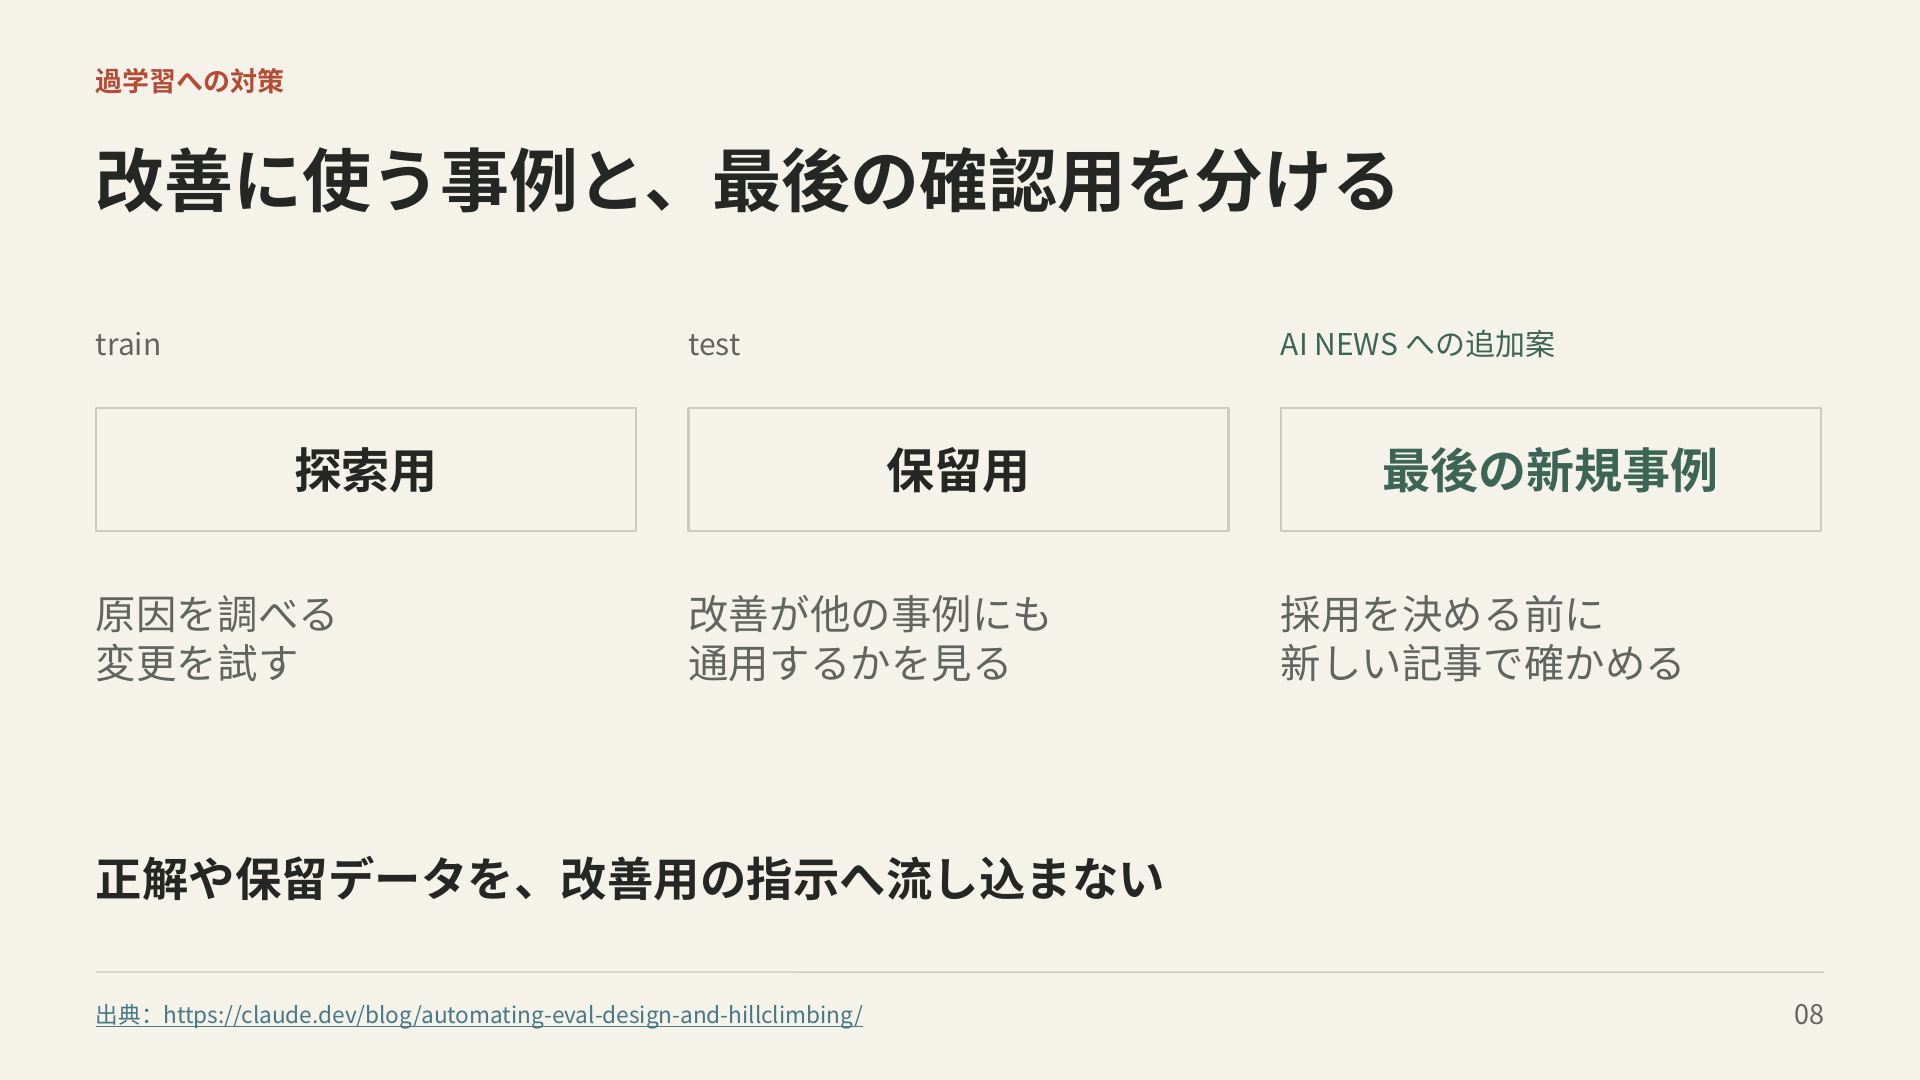
改善用の例題と、確認用に取っておく例題を分けることには意味がある。ただし、保留データの点数を何度も見て、最も良かった指示を選び続けると、そのデータへの適応が起きる。問題文を直接見せなくても、点数という情報を通じて選択は影響を受ける。これは反復的なデータ分析で知られる問題だ。Google Researchによる解説
AI NEWSの制作では、同じ企業発表を題材にした記事や、表現だけ違う原稿を別々の例題として数えると、分割しても似た情報が両方に入ってしまう。そこで題材や元資料ごとにまとめて分け、調整に使わない最終確認用の題材を別に確保する方法を提案する。
最終確認を見てさらに直した場合、その題材は次の改善用へ回す。再び「完全に未見の確認」とは呼ばず、新しい題材で確かめる。小規模な評価の点数には限界があるため、公開後の訂正や読者の疑問も、次の例題を作る材料にする。
予算と停止条件を、実行前に決める
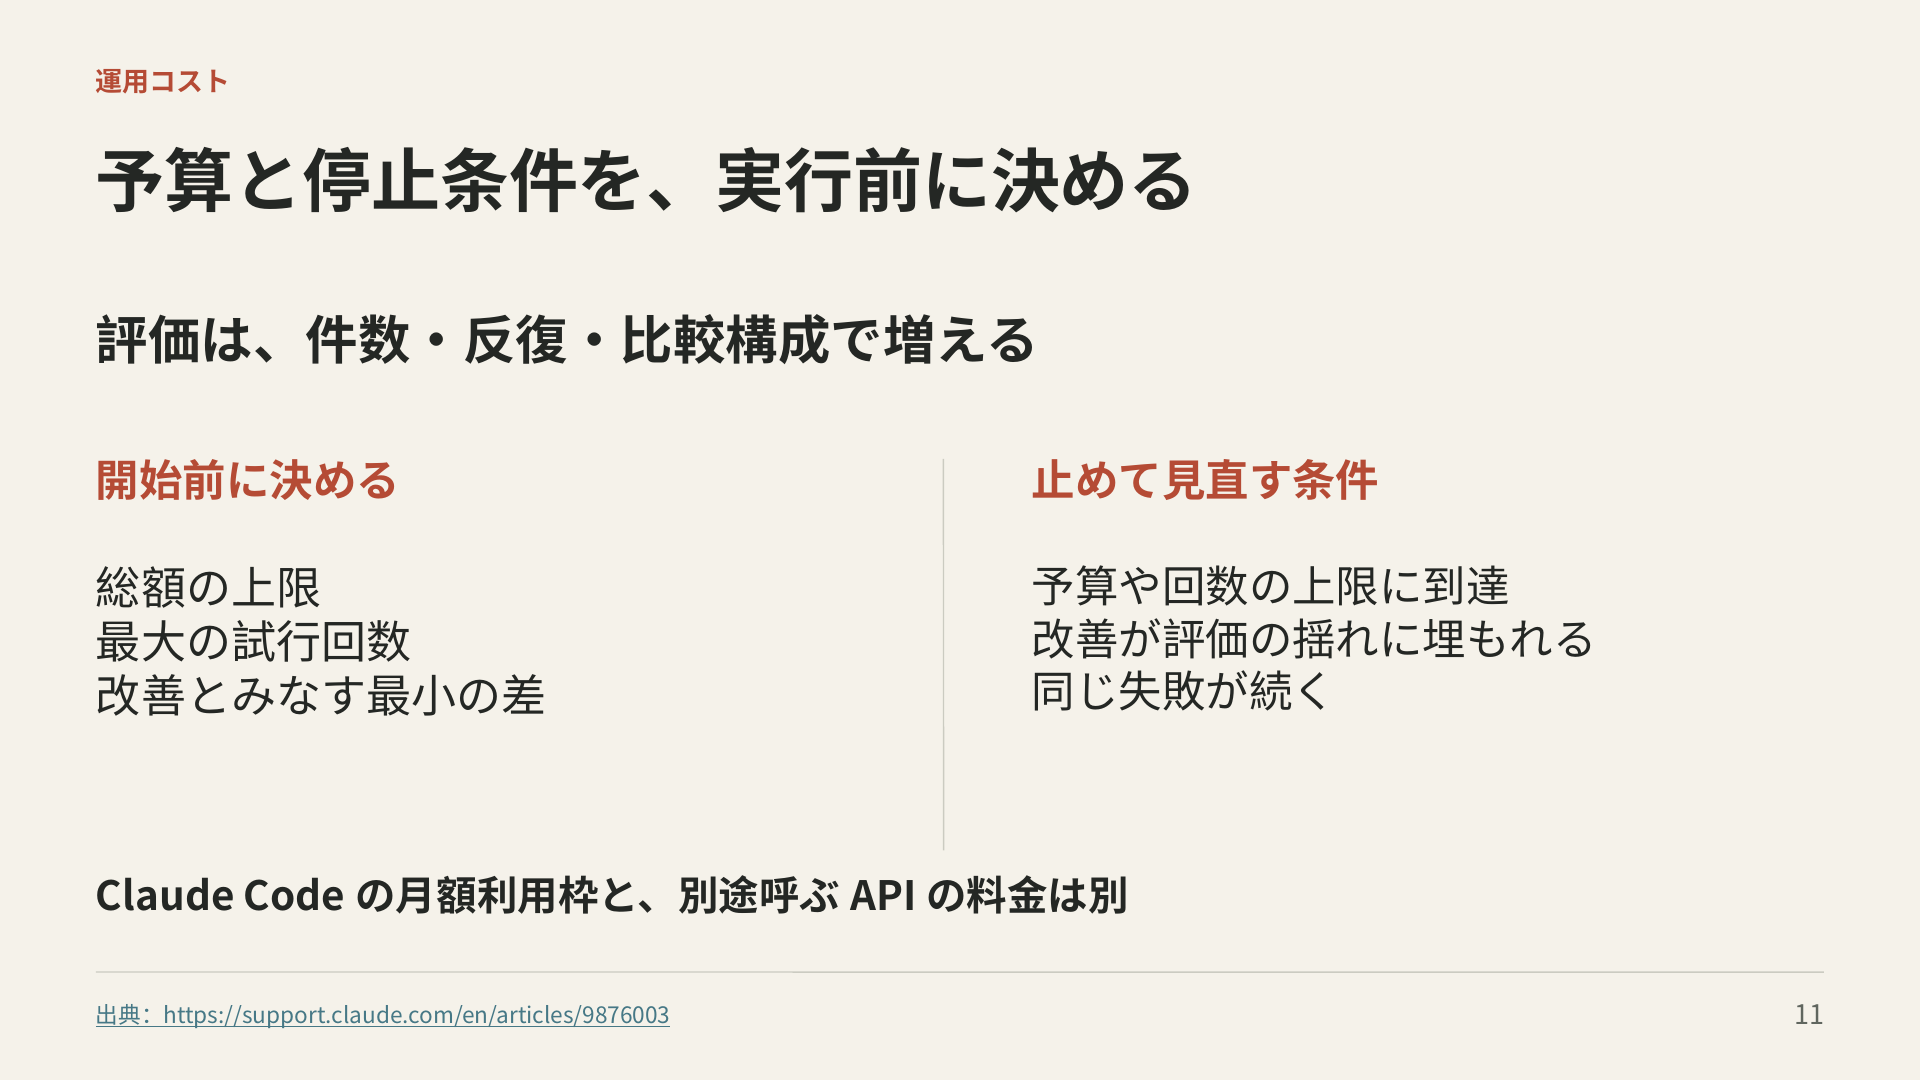
評価には出力の生成、採点、比較、修正のための処理がある。まず少数の例で一巡させ、対象件数、繰り返し回数、改善ラウンド、採点用AIの利用分を含めて見積もる。試行回数を増やす前に、金額と時間の上限を決めておきたい。
月額プランの枠とAPI利用料にも注意が必要だ。Pro・MaxでのClaude Code利用はClaudeと利用上限を共有する一方、APIとConsoleは別の課金体系だ。環境変数ANTHROPIC_API_KEYが設定されていると、Claude CodeがAPIキーを優先し、API利用料が発生する場合がある。月額プランでの利用、APIとの違い
したがって「Claude Code内の作業だから評価用のAPI呼び出しも月額に含まれる」とは考えず、生成と採点の呼び出し先、認証方式、請求先を確認する。料金はモデルと入力・出力量によって変わるので、他社事例の単価をそのまま予算にしない。
停止条件の例は、予算または時間の上限到達、重大な誤りの発生、採点の不一致の増加、改善がばらつきと区別できない状態だ。差がはっきりしなければ、良くなったと結論を急がない。例題や採点方法を見直すべきか、追加測定に費用をかけるかを判断する。
最初に作るのは、失敗を説明できる小さな評価
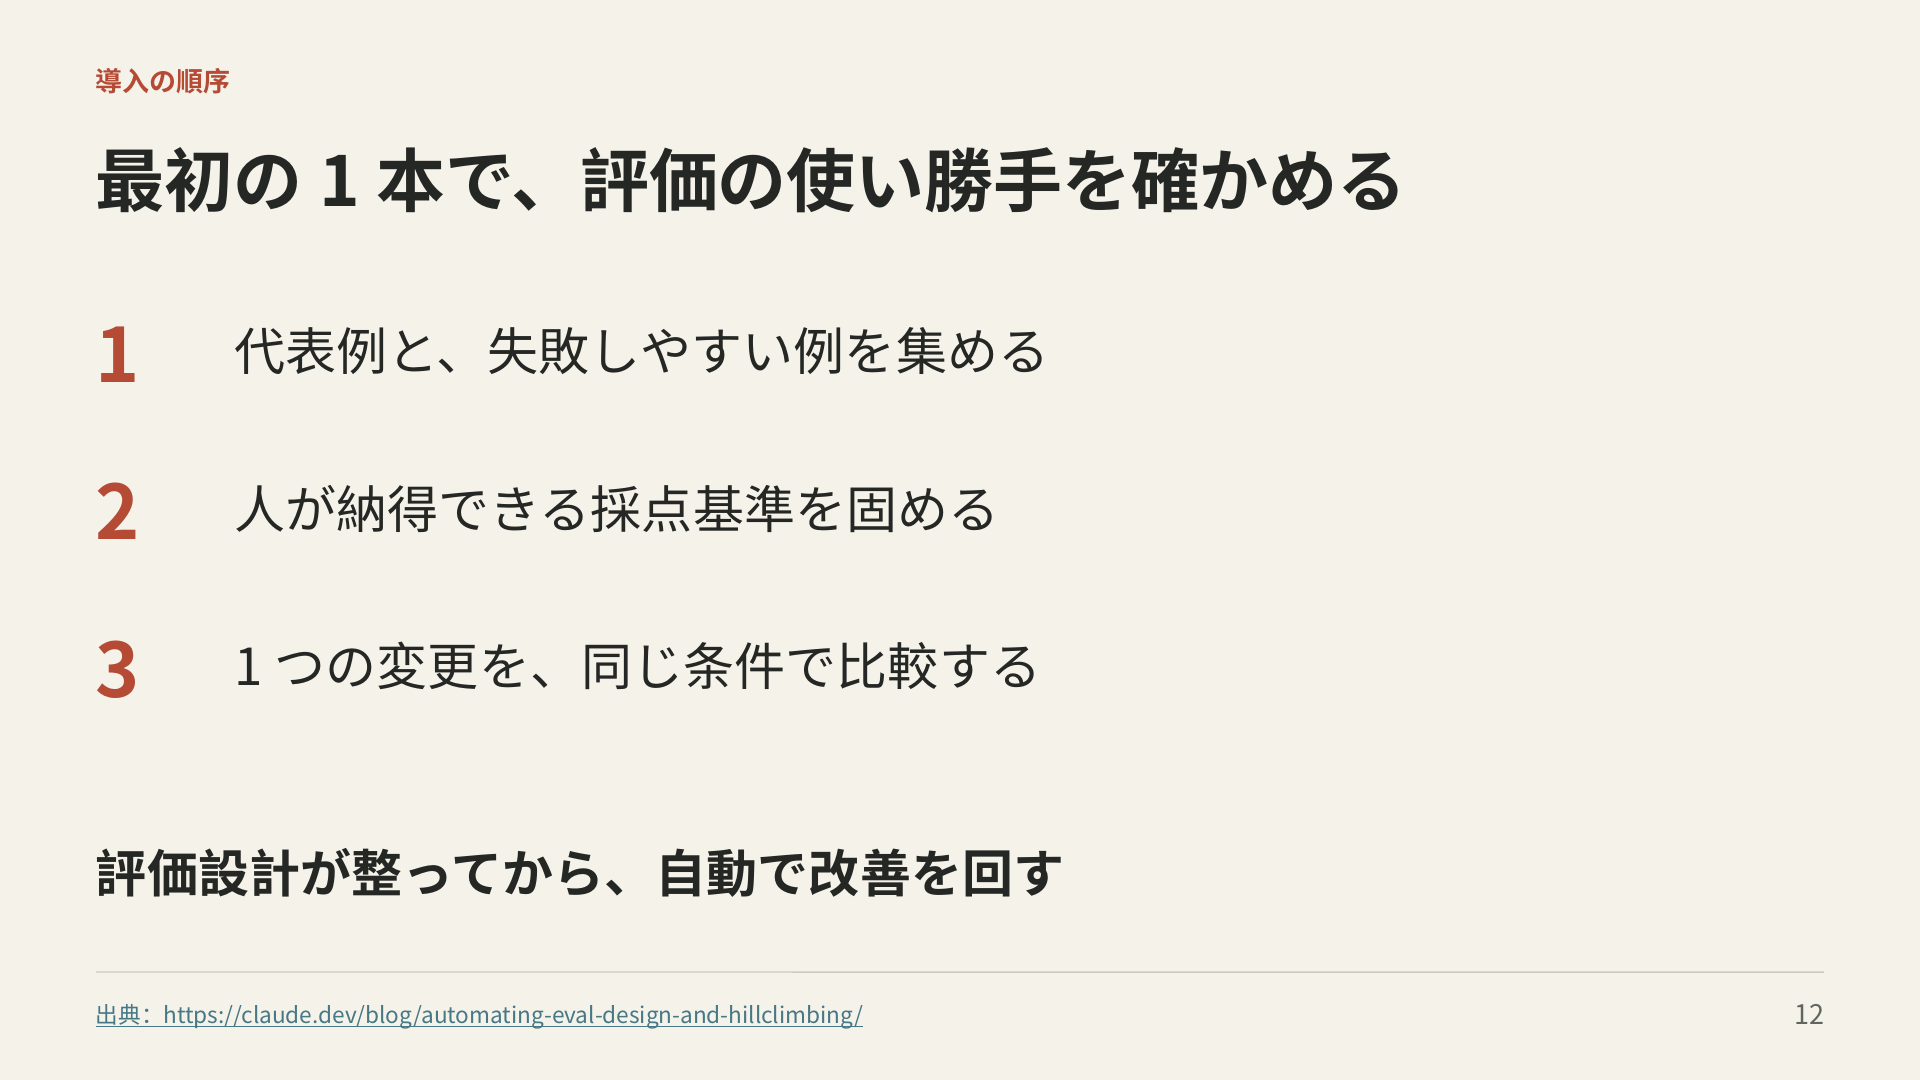
始めるなら、直近の記事から日付、数字、引用、解釈、スライドの各問題を拾い、少数の例題と正しい判断をそろえる。公式は、Claude Codeを更新した上で「/claude-api build-eval」、評価が整ったら「/claude-api hillclimb」を使う手順を案内している。導入手順
最初の目標は、高い点数を掲げることより、どの誤りを検出でき、どこは人の確認が必要なのかを説明できる状態にすることだ。プログラムのテスト通過、採点の妥当性、記事品質の改善、売上への効果は、それぞれ確かめる対象が違う。収益化を目指す制作でも、その区別を保つことが、過大な期待や無駄な反復を減らす。
指示を変え、例題で比べ、問題箇所を読み、次の指示へ戻す。この記録が残れば、うまくいった一回の出力に頼らず、次の記事にも引き継げる。build-evalとhillclimbを生かす出発点は、自分の仕事で何を「良い」と呼ぶのかを、確認できる言葉にすることだ。
AI NEWSで実装した範囲と、これから確認すること
AI NEWSでは独自のオフライン品質チェックを実装し、構造チェックと意味のレビューを分けて「合格」「不合格」「要人手確認」を記録しています。20件のローカルテストと12件の合成回帰例を確認しました。スライド内の評価工程は設計案であり、現時点の実装は文章・出典参照・数値トークン・図解データの対応検査とレビュー記録の管理です。出典本文と図解の意味を自動で検証したものではなく、Claude Codeのbuild-eval/hillclimb、有料APIを使う評価、記事品質の改善効果は未実施・未検証です。
この新記事にもチェックを適用し、構造の違反は0件でした。主要な主張と図解の意味の照合は、出典抜粋とレビュー記録をそろえて確認する必要があるため、総合判定は「要人手確認」です。プログラムの動作確認と、記事の意味や改善効果の評価は分けて扱います。