AI NEWS · 図解と解説
GoogleはAI競争から脱落していない
Geminiの現在地とdotsやMuseが直面する3つの壁
2026年10月3日時点 · 番組収録:2026年10月2日
番組の発言は要旨です。各社の公表内容、今井翔太氏の見解、本稿の分析・仮想例を区別して記載しています。図はタップすると原寸画像を別タブで開けます。
Gemini 4 Argonが示したGoogleの競争力と、個人を継続的に支えるAIの可能性。今井翔太氏の議論を手がかりに、性能の数字からは見えにくい実用化の条件を整理する。
Googleは最先端のAI開発競争から脱落したのか。パーソナルAIは、いよいよ生活や仕事を任せられる段階に入ったのか。2026年10月2日収録のTBS CROSS DIG「AI QUEST」で、AI研究者の今井翔太氏が論じた二つのテーマは、こうした問いにつながっている。
Gemini 4 Argonについて、今井氏はGoogleが競争に残っていることを示したと評価した。OpenAIのdotsやMetaのMuseが目指すパーソナルAIにも期待を寄せつつ、普及には三つの壁があると指摘する。各社の同時参入、失敗が許されにくい仕事、そして外部サービスへの接続制限だ。
二つの話題に共通するのは、AIの価値を一つの性能順位だけで判断できないという点である。どの仕事に強いのか。利用者の事情をどれだけ理解し、許された範囲で仕事を終えられるのか。そこまで見て初めて、日常で使えるAIの姿が見えてくる。
出典:TBS CROSS DIG「AI QUEST」 本稿の主な対象は4分32秒〜26分47秒、28分15秒〜43分35秒。発言は要旨であり、以下の具体例や評価上の整理には本稿の分析を含む。
Geminiが示した競争力をどう読むか
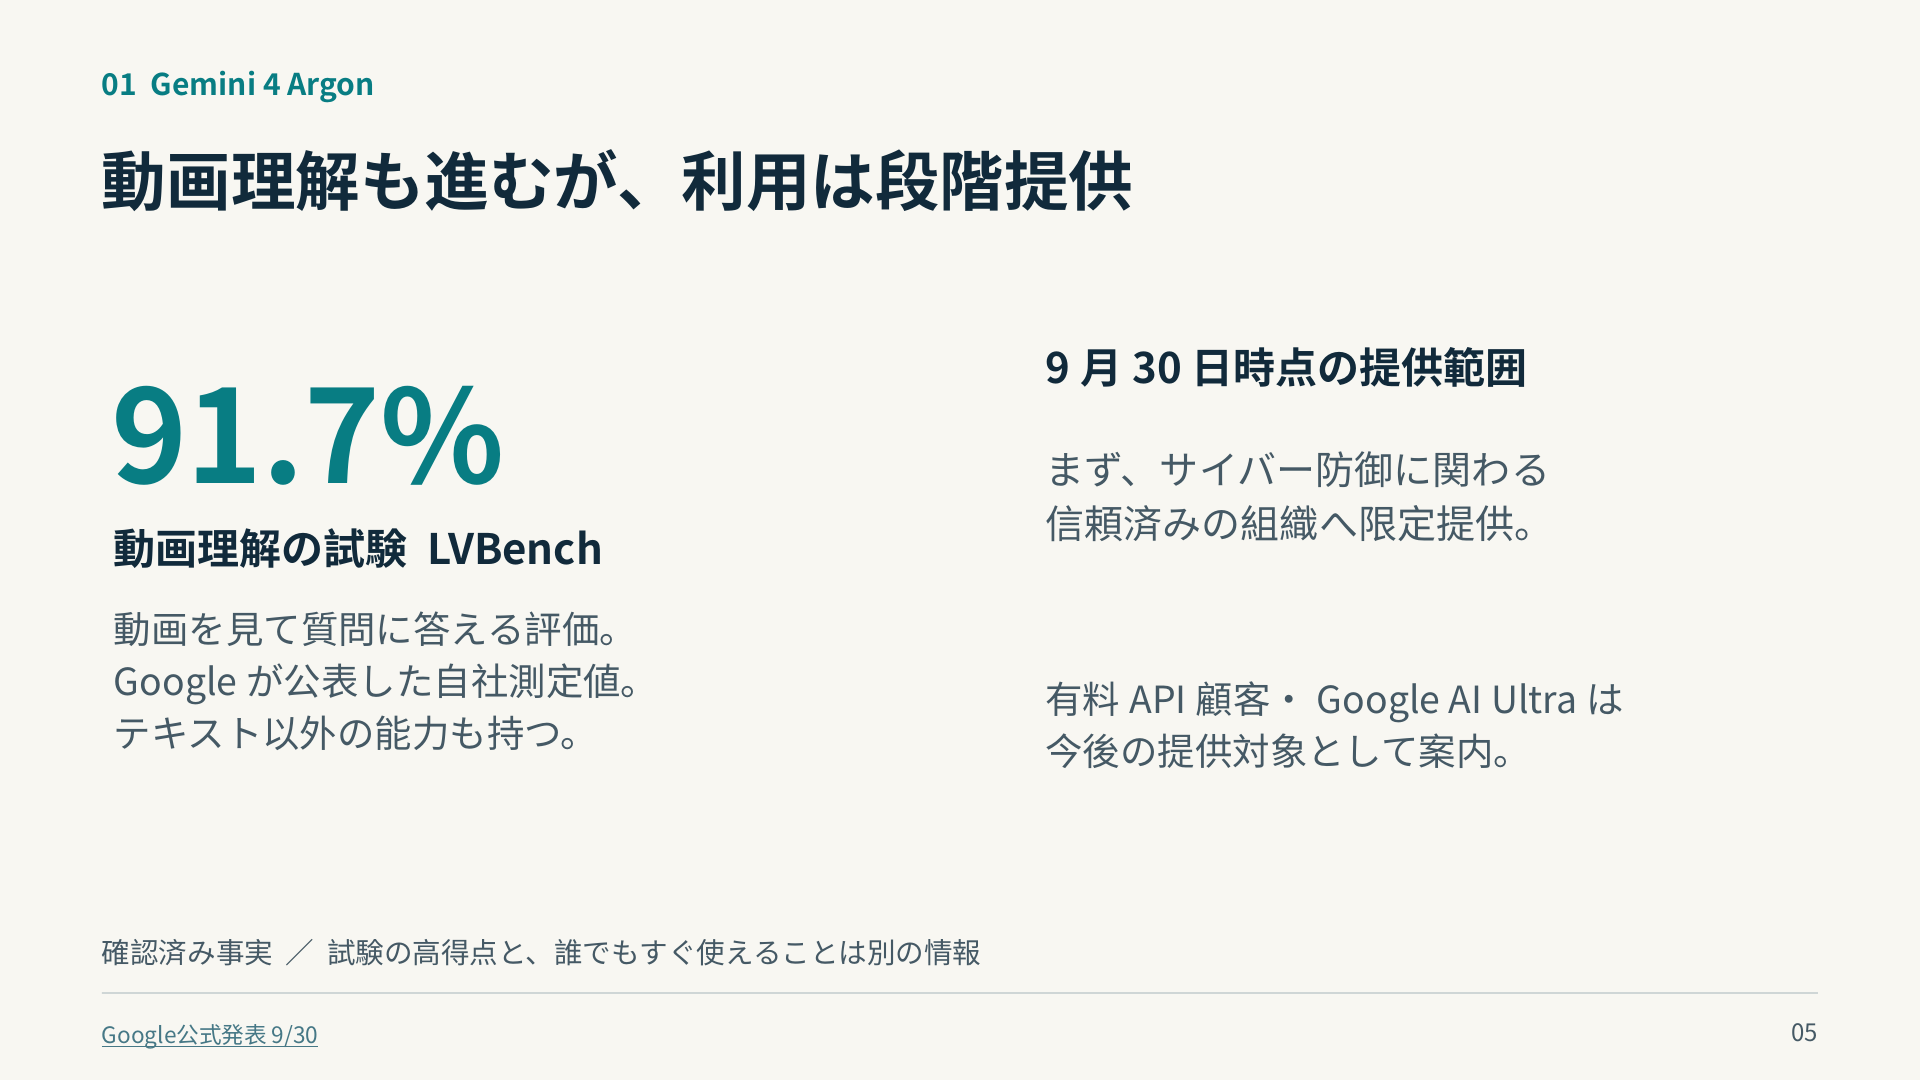
Googleが9月30日に発表したGemini 4 Argonは、まずサイバー防御に関わる信頼済みの組織へ段階的に提供される。一般の開発者や消費者への展開は今後の計画として説明されており、発表されたことと、誰でも使えることは区別する必要がある。
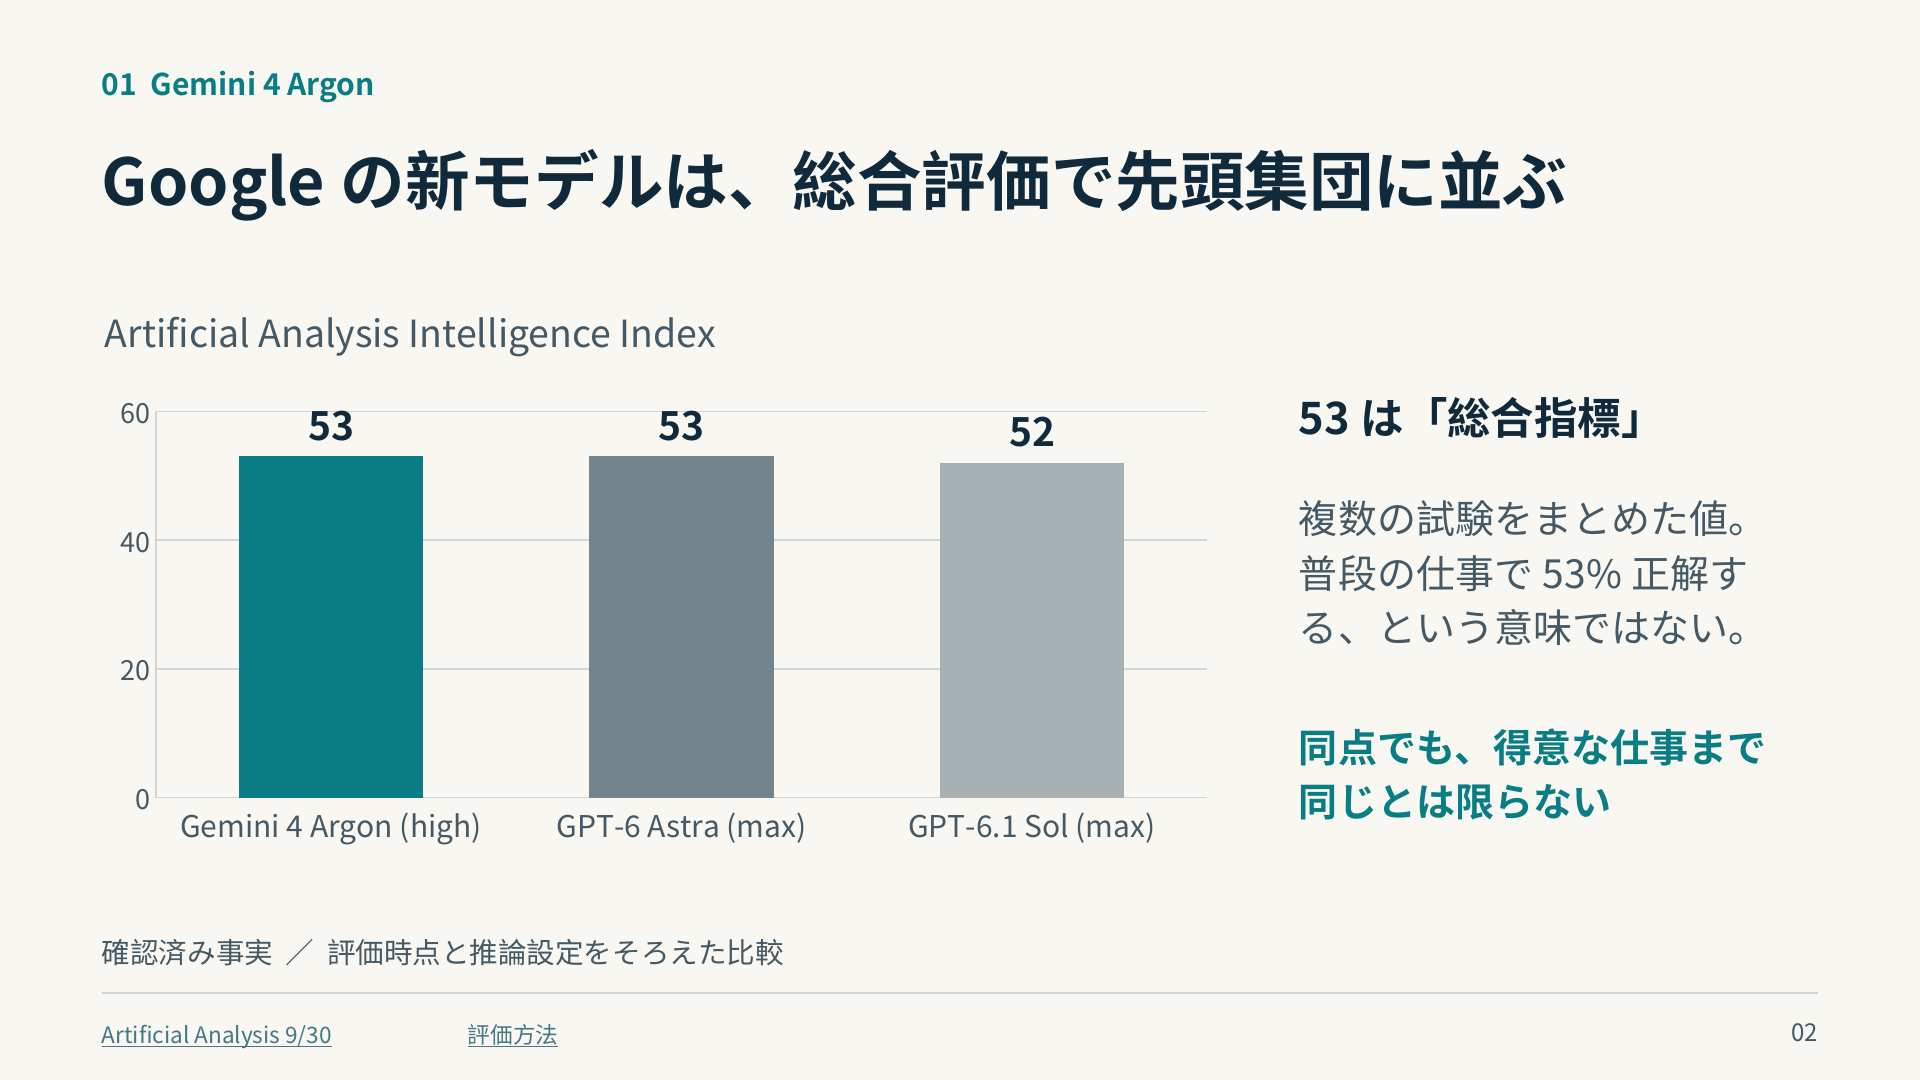
発表時点の注目材料は、第三者評価で既存の最先端モデルに並ぶ結果を示したことだ。Artificial Analysisの複数分野をまとめた指標「Intelligence Index」では、Argonのhigh設定が53、GPT-6 Astraのmax設定も53だった。これはGoogleが有力な競争相手であり続ける根拠になる。ただし、総合点が同じでも、すべての作業で同等に使えるとは限らない。
今井氏は、日常的な文章のやり取りに強いAIと、Googleがすでに持つサービスや利用者との接点の組み合わせを評価する。例えば、会議資料から要点を拾い、メールの下書きを作る仕事では、回答の質に加えて、必要な資料へ自然にたどり着けることが使いやすさを左右する。普段使うサービスの中で役に立つなら、利用者がAI専用アプリへ移動する手間も減らせる。
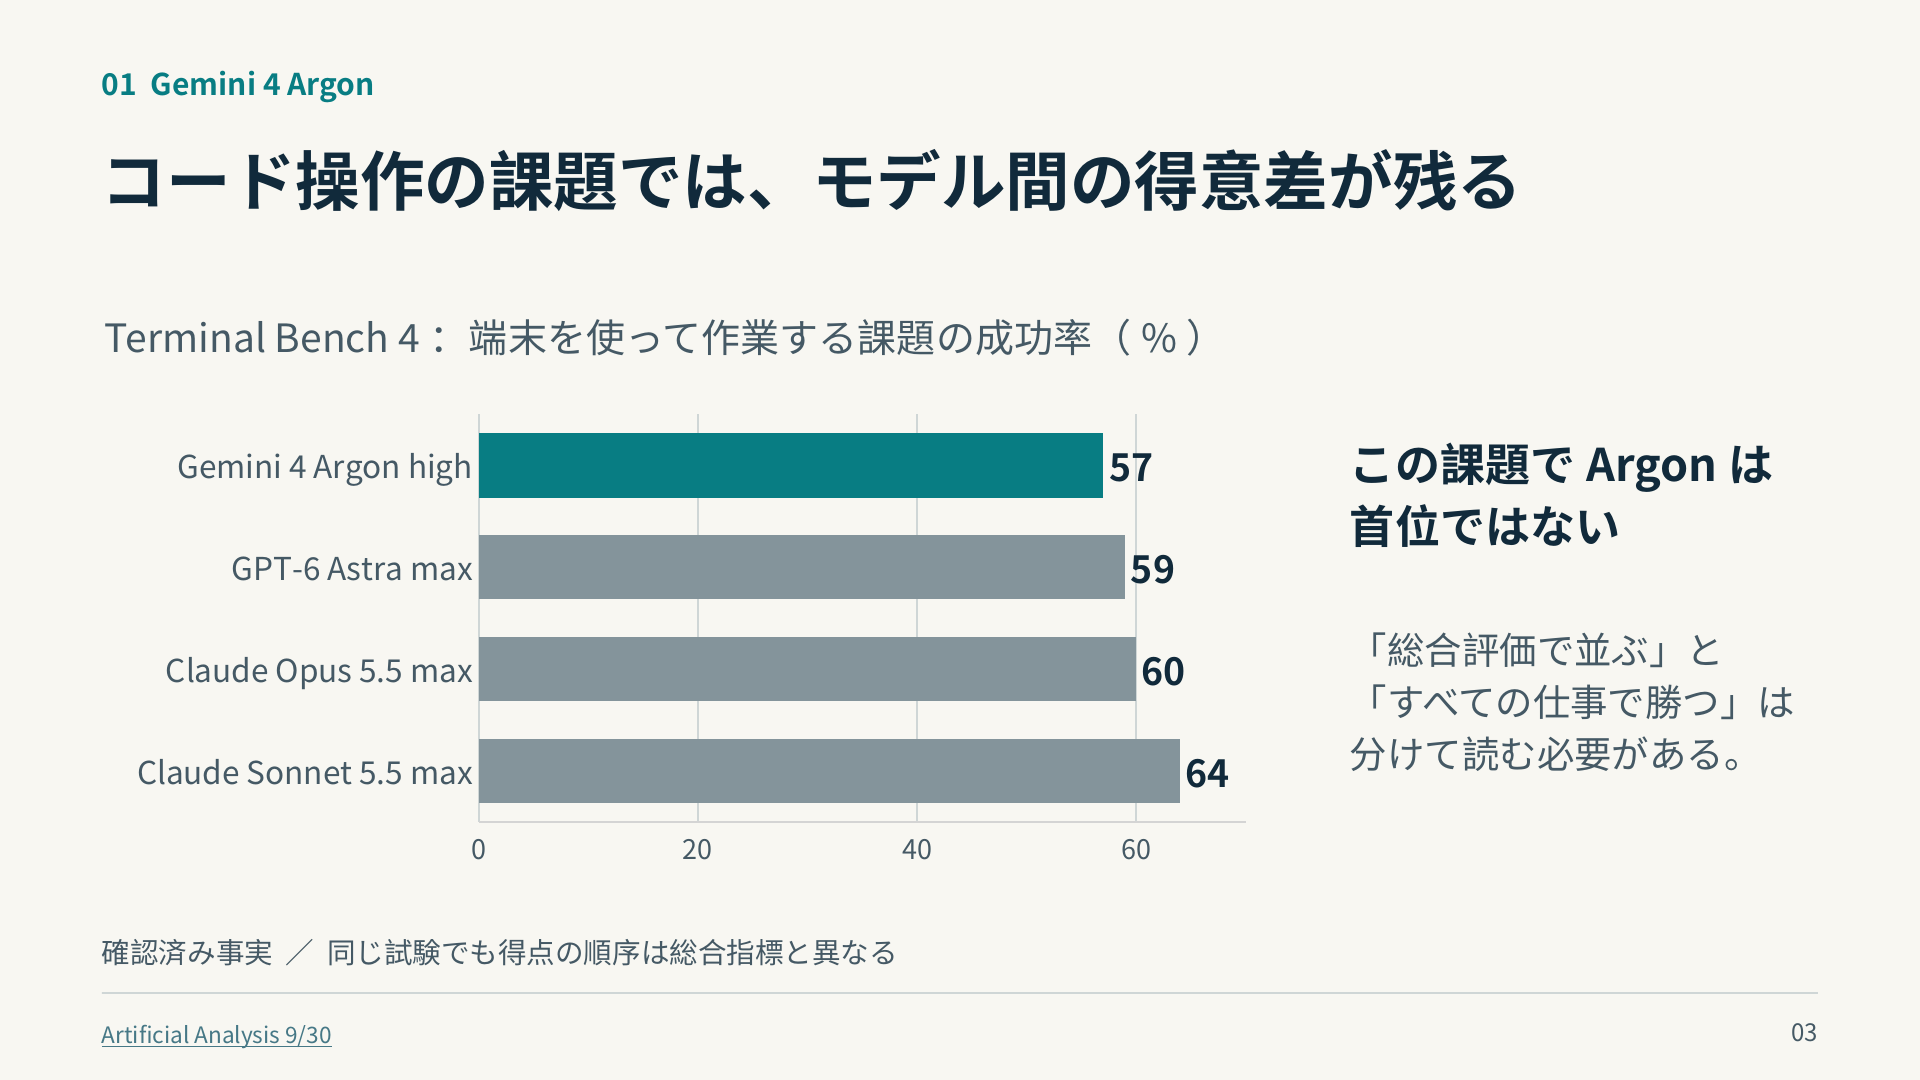
一方、コマンド入力型の環境で複雑な作業を解かせる「Terminal-Bench 4」では、同じAAの評価でArgonのhigh設定は57%、Claude Sonnet 5.5のmax設定は64%だった。開発支援を求める利用者は、コードが動くか、修正が正しいかを厳しく見る。今井氏も、コーディング分野の競争力は別に検討すべき課題としている。文章作成、業務支援、ソフトウェア開発を一括して「勝った」「負けた」と評することには無理がある。
開発では、短い関数を書けることと、既存の大きなプログラムを読み、影響範囲を調べ、テストまで通すことにも差がある。モデルに組み合わせる開発ツールや実行環境によって結果も変わる。導入を判断するなら、普段の不具合修正や小さな機能追加を同じ条件で試し、完成までに人がどれだけ直したかを比べたい。
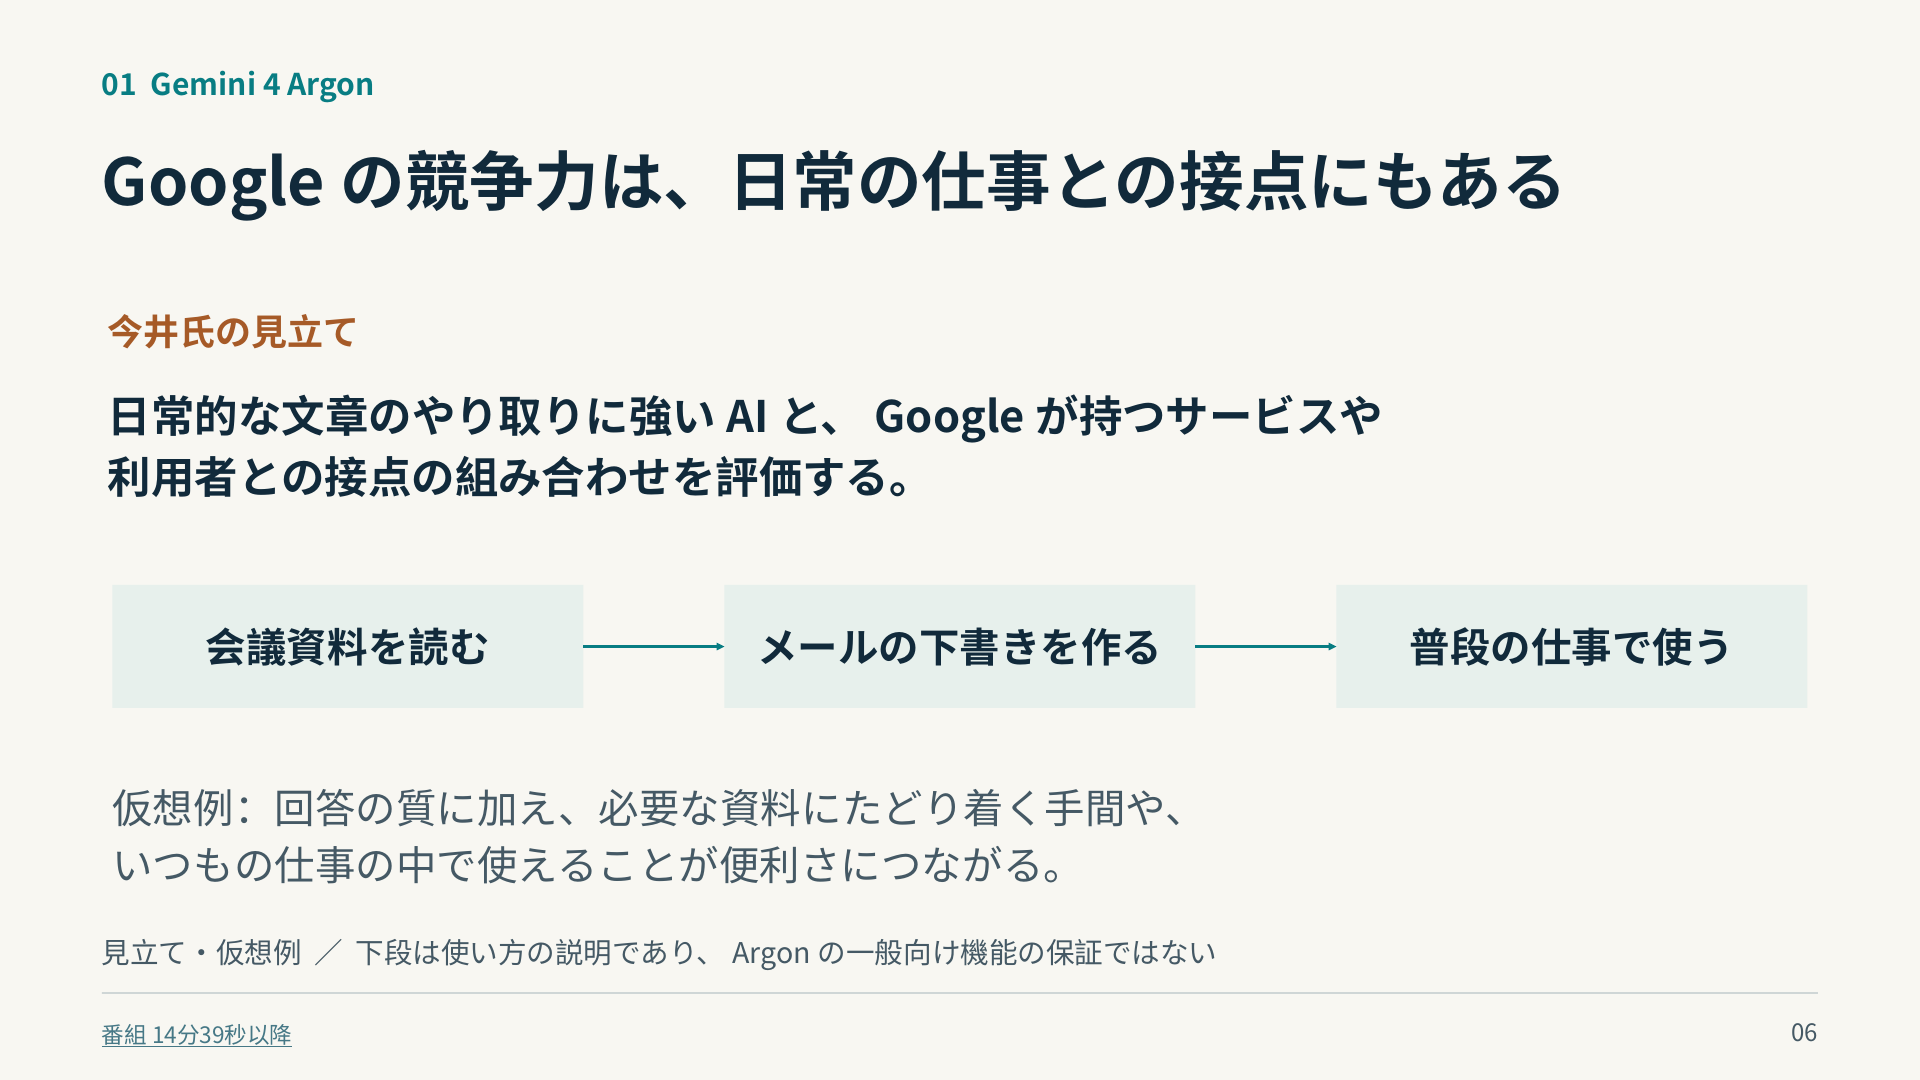
出典:Google公式発表、Artificial Analysisの評価。評価設定を併記した。今井氏の見解は番組14分39秒以降。
幻覚率15パーセントは正答率85パーセントではない
今回の改善で読み違えたくないのが、ハルシネーション、つまり事実に反する情報をもっともらしく答える傾向の評価だ。Artificial Analysisの「AA-Omniscience」では、Argonの幻覚率は15%だった。一方、同じ評価での正答率は50%。この二つは矛盾しない。
この評価の幻覚率は、全問題のうち何問間違えたかを示す数字ではない。正解でなかった応答、すなわち不正解、部分正解、未回答を合わせた中で、不正解がどれだけあるかを表している。そのため、知らないことに答えずにとどまれるモデルは、幻覚率を低くできる。「15%しか幻覚しないから、残り85%は正しい」とは読めない。
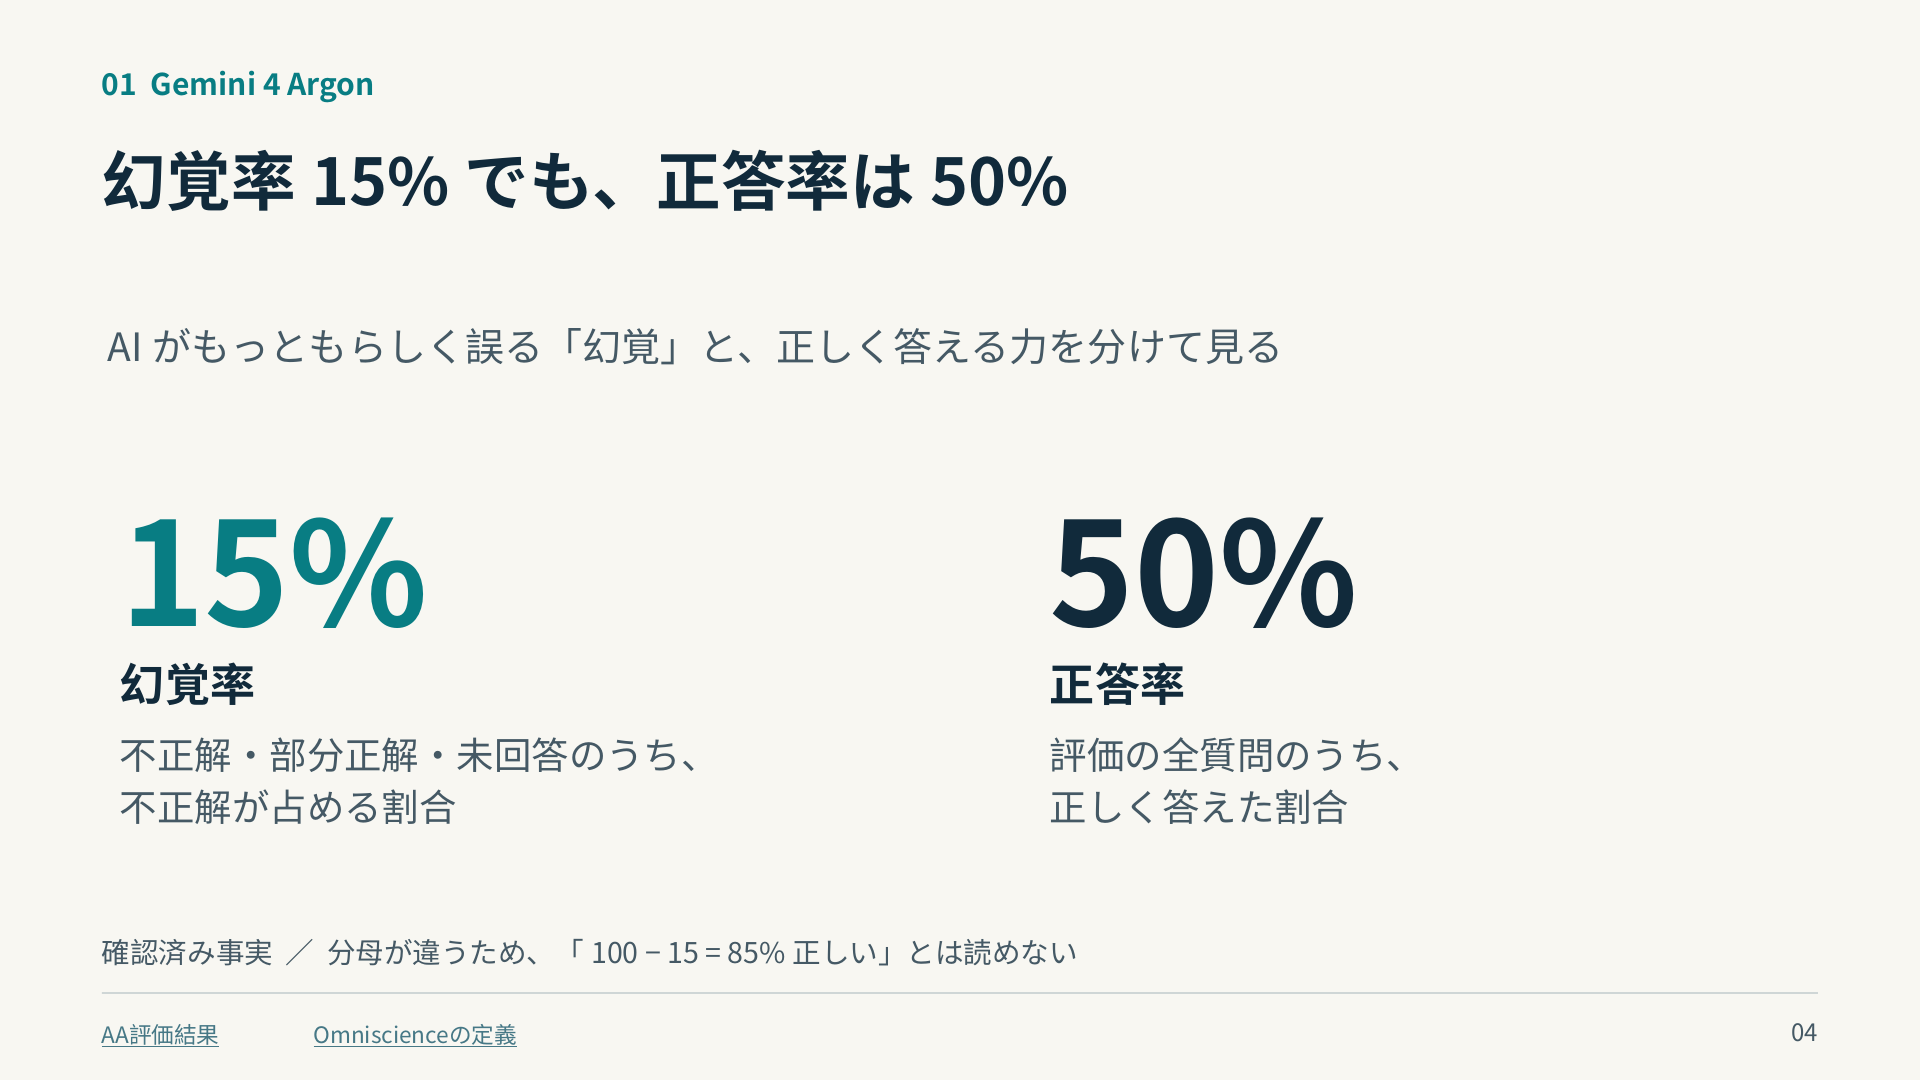
仕事では、この違いが大きい。存在しない統計を自信満々に資料へ書き込まれるより、「確認できない」と伝えられる方が、調査をやり直す判断をしやすい。ただし、答えを控える能力が高くても、必要な情報を調べて正しくまとめられるかは別途確かめる必要がある。幻覚の少なさと、仕事を完了する力の両方を見るべきだ。
また、番組で今井氏が発表の重点を実務寄りと捉えたことを、画像や動画を扱う能力がなくなったという意味に取るべきではない。Googleの公式発表は動画理解の評価も掲載している。総合指標の対象も確認しながら、実際に使いたい入力や仕事に合うかを判断するのが妥当だ。
出典:AA-Omniscienceの指標定義、Argonの評価結果、Google公式発表。
パーソナルAIが覚えるのは利用者ごとの事情
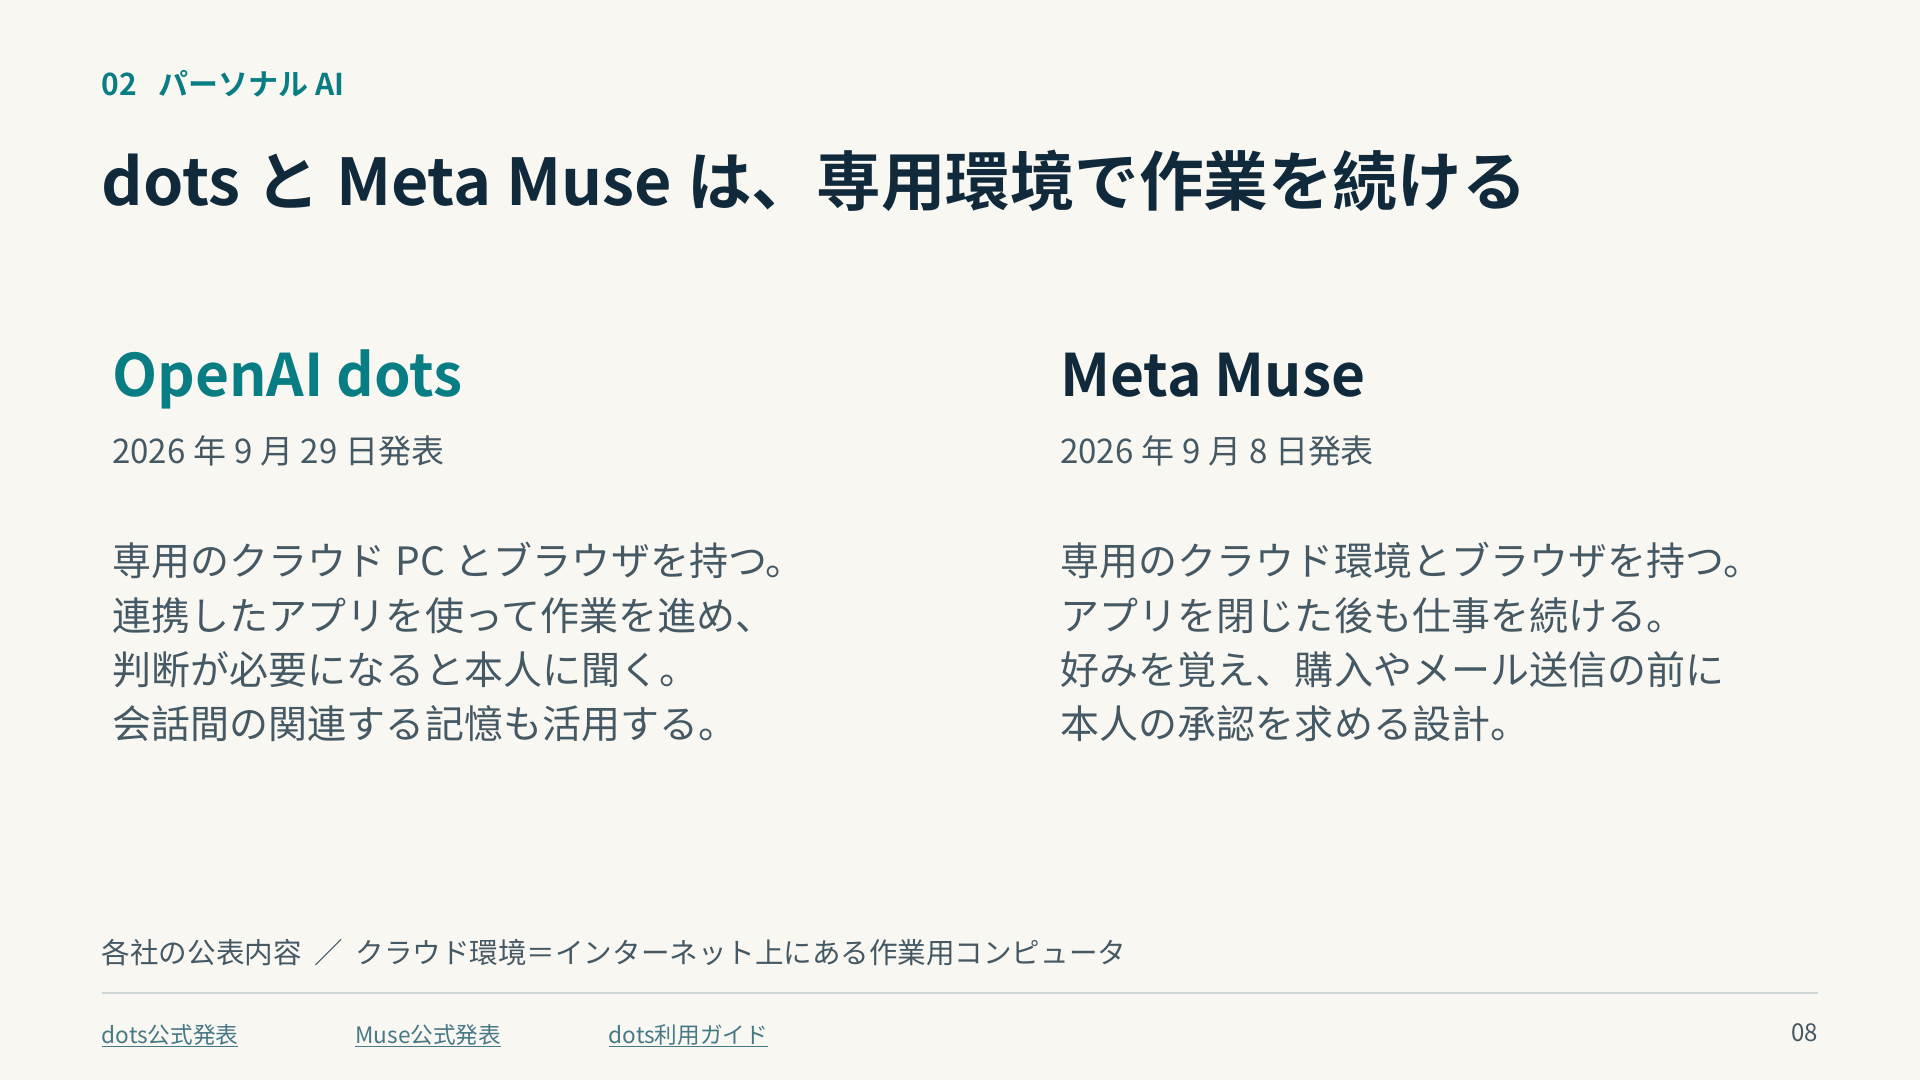
話を個人向けのAIへ移そう。dotsやMuseが目指すのは、質問されたときに答えるだけでなく、会話の合間にも作業を進めるアシスタントである。OpenAIの公式ガイドは、dotsが専用のクラウド上のコンピューターや接続したアプリを使えると説明する。MetaもMuseについて、専用のクラウド環境とブラウザを持ち、アプリを閉じた後も作業を続けると説明している。
ここでいうAIエージェントとは、依頼の達成に向けて手順を考え、必要な道具を使って作業する仕組みを指す。Geminiのような基盤となるモデルの性能と、記憶、アプリとの連携、権限の管理を備えたサービス全体の使い勝手は、分けて考える必要がある。
こうしたAIの価値を考えるとき、重要なのは継続的な個人の文脈だ。例えば、毎月の報告書を手伝ってもらう際、読み手は誰か、前回どこを直したか、どんな表現を避けたいかを毎回最初から説明するのは面倒だ。過去のやり取りを適切に引き継げれば、次回は本題から始めやすくなる。生活の予定でも、単に空いている時間を探すだけでなく、本人が移動や準備に必要とする余裕を理解できれば提案の質は変わる。
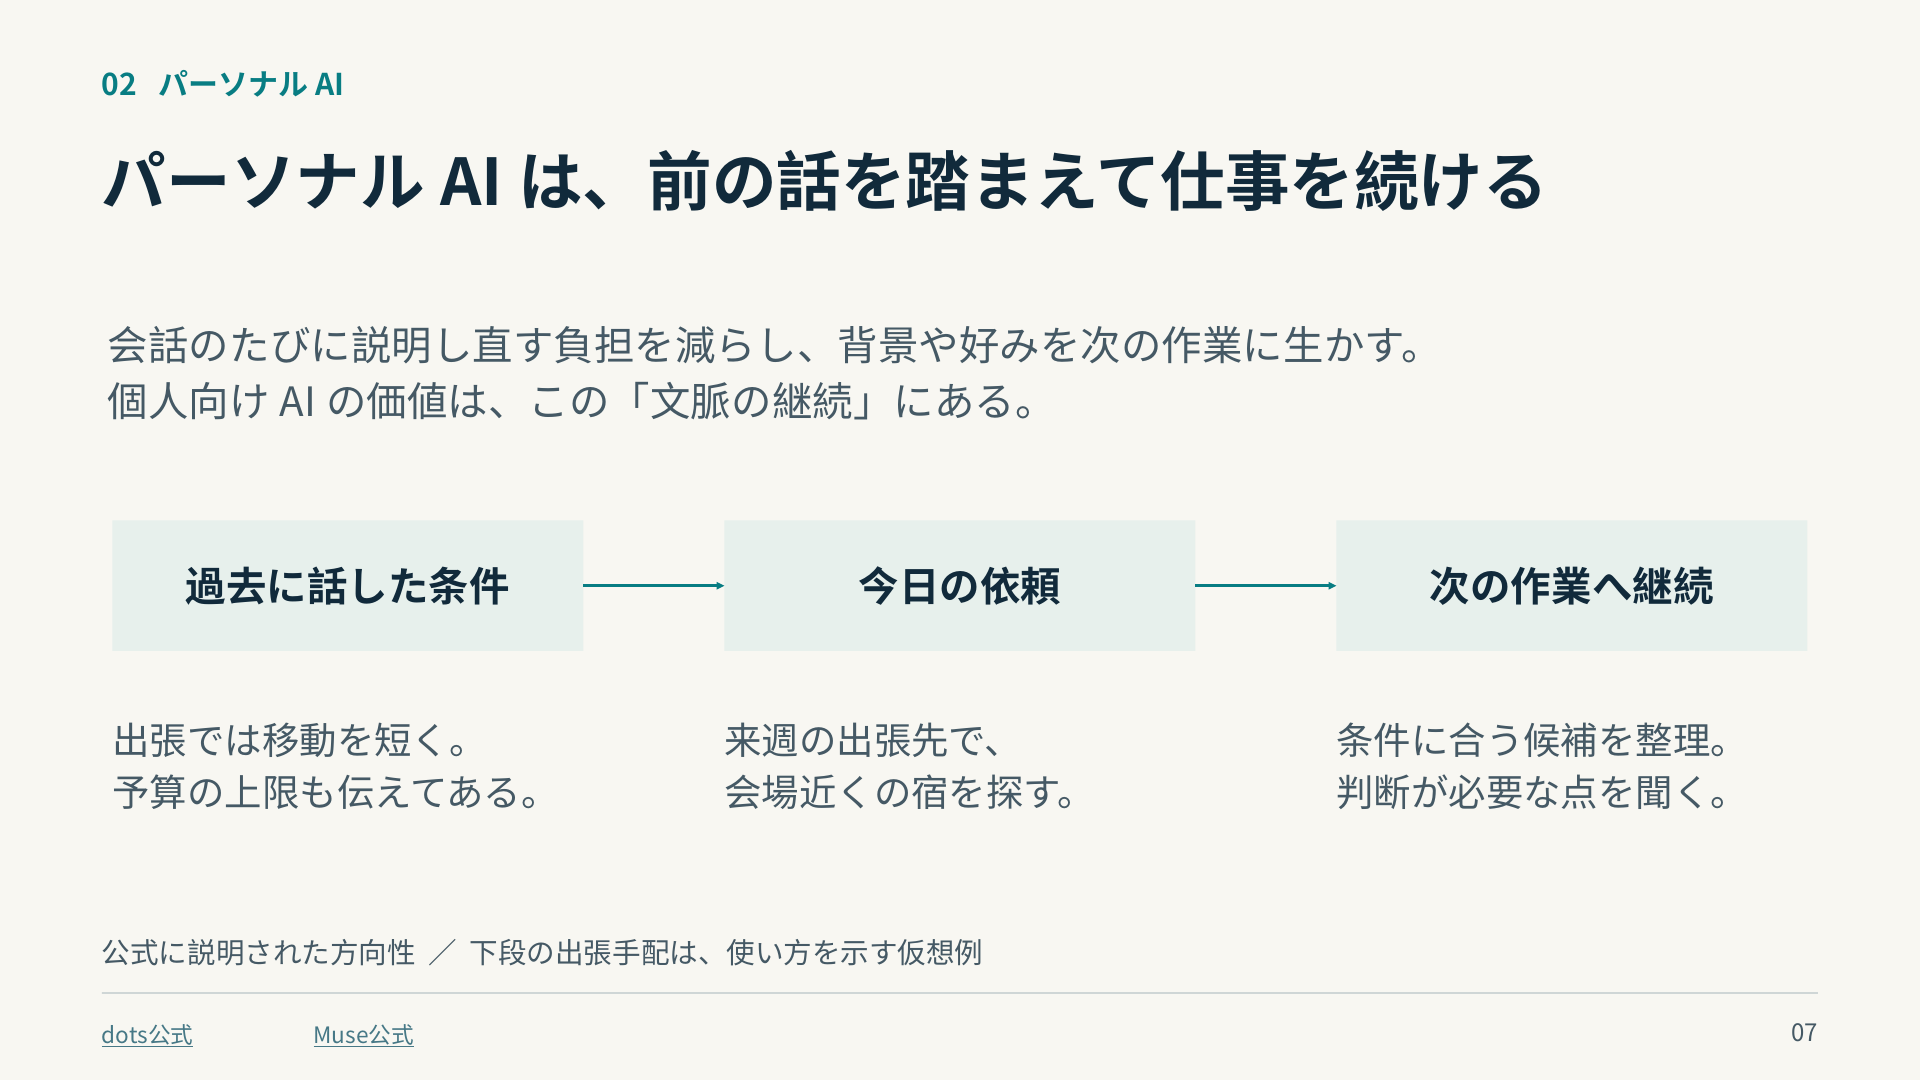
今井氏は、こうした関係の積み重ねが、利用者がAIを使い続ける理由になり得ると見る。一般的な試験で少し上回る別のAIが現れても、自分の事情を説明し直す負担が大きければ、すぐには乗り換えないかもしれない。企業にとっても、性能競争だけでは築きにくい強みになるという見立てだ。
もっとも、記憶があることと、本人を正しく理解していることは同じではない。過去の希望が今も有効なのか、仕事と私生活の情報をどこまで使ってよいのか。利用者が記憶を確認し、訂正し、不要なものを消せることが、長く任せるための前提になる。
OpenAIは会話や好みを継続して使う仕組みを説明し、Metaも接続するアプリを選び、特定の情報を忘れさせられるとしている。こうした公称機能があっても、過去の会話をすべて正確に覚え、常に適切に使えると保証されたわけではない。本人の希望が変わったときに修正を受け入れることも、信頼の一部だ。
出典:dots公式ガイド、OpenAIのdots発表、MetaのMuse発表。継続利用の強みに関する今井氏の見解は番組30分42秒〜32分5秒。
第一の壁は各社が同時に同じ方向へ進むこと
今井氏の第一の懸念は、パーソナルAIという方向性を多くの企業が同時に目指していることだ。あるサービスが個人の事情を十分に覚え、手放しにくい存在になる前に、利用者が複数のサービスへ分かれる可能性がある。
例えば、仕事の資料はあるAI、買い物は別のAI、スマートフォンでの相談はさらに別のAIという使い分けが続けば、各サービスが理解する本人像も分かれる。一社に長い利用履歴が蓄積するという先行者の優位は、当然には生まれない。既存サービスを通じて日常的に利用者と接している企業が有利になり得る、というのが今井氏の見方だ。
ただし、競合が多ければ普及が遅れると決まったわけではない。利用者にとっては、得意な仕事や情報の扱い方を比べて選べる利点もある。今後確かめたいのは発表の数より、使い続けたときに説明の手間が減るか、自分の事情に合う提案が増えるかだ。
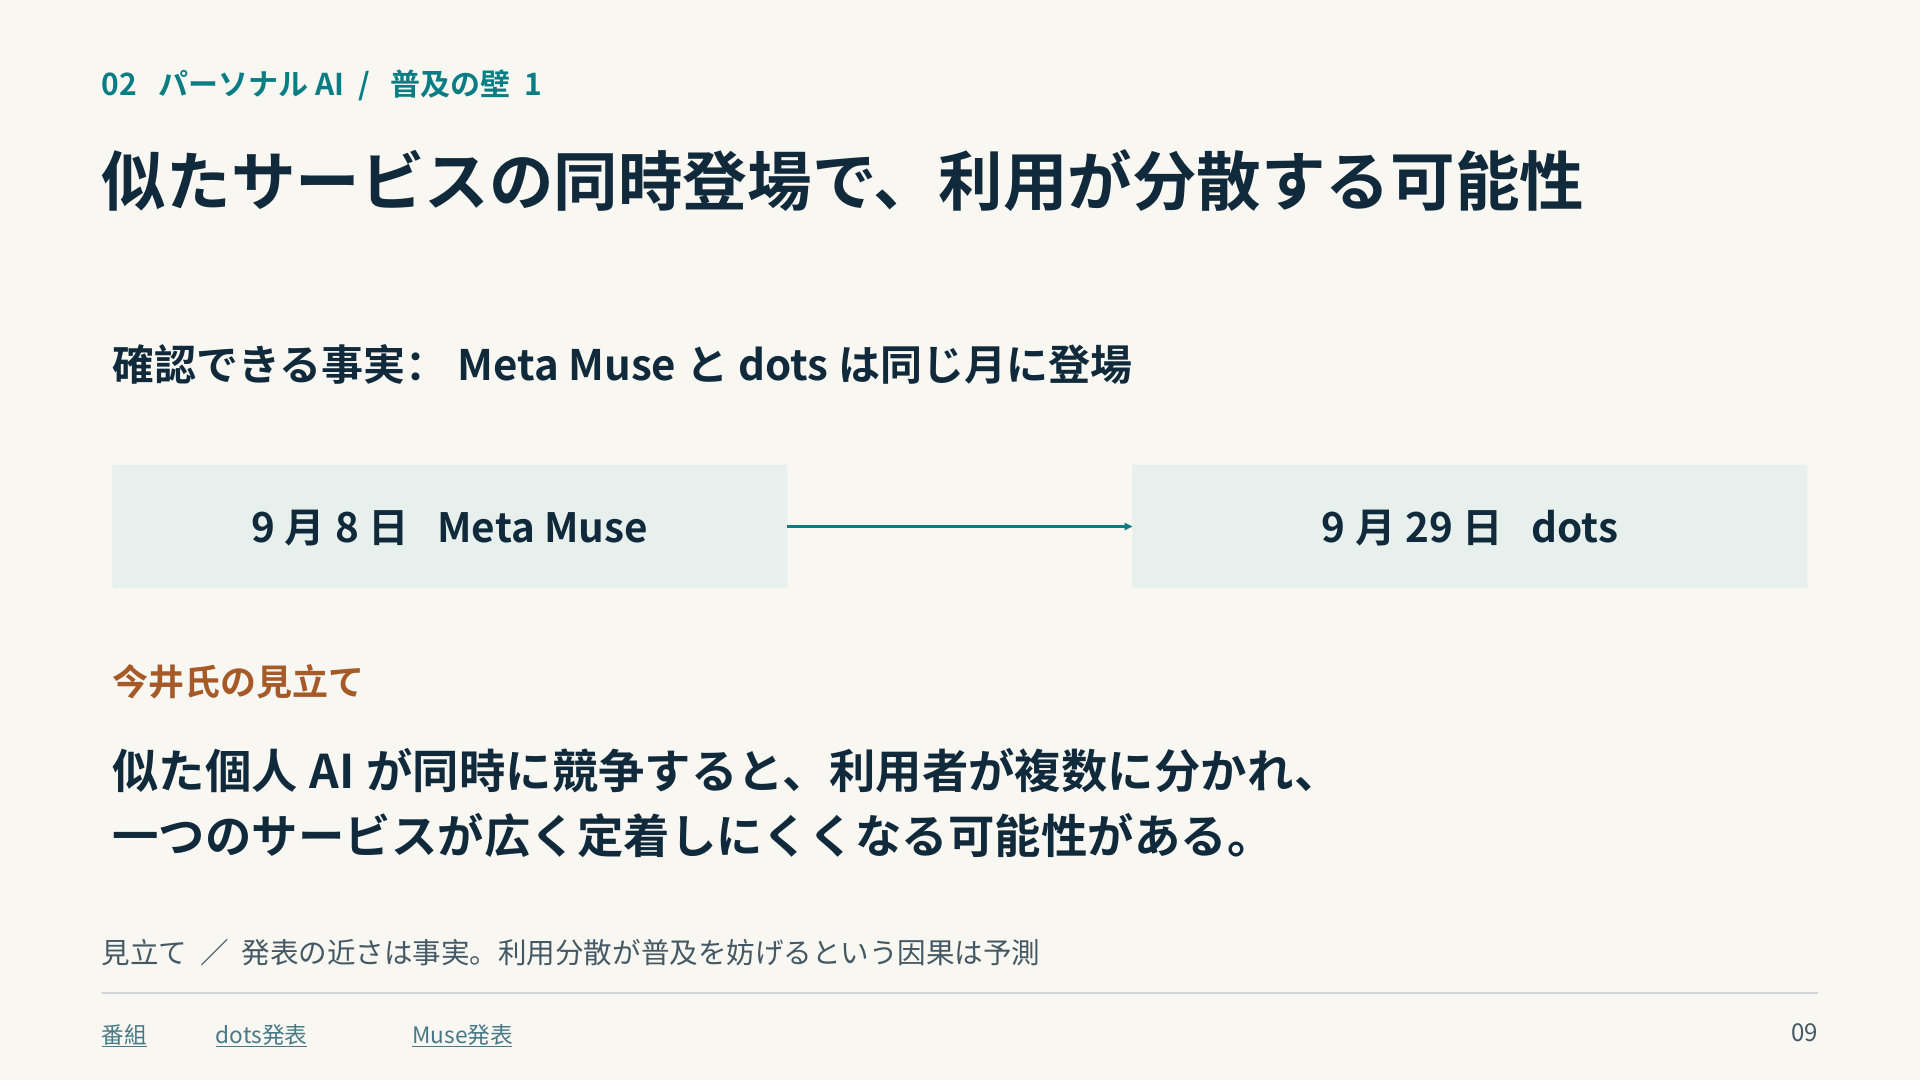
出典:番組32分5秒以降。利用者の分散と先行者優位への影響は今井氏の見通しであり、市場で確認された結果ではない。
第二の壁はできて当たり前の仕事の難しさ
第二の懸念を、今井氏は「加点方式」と「減点方式」という言葉で説明する。文章案や試作品は、役立つアイデアが一つあれば価値になる。仕上がりが不十分でも、採用する部分を選び、残りは修正できる。これが加点型の仕事だ。
旅行の予約や買い物では事情が違う。希望した日付、人数、価格条件で手続きができることが出発点であり、気の利いた工夫よりも、条件を間違えないことが重要になる。例えば、良いホテルを見つけても宿泊日が一日ずれていれば、予定の組み直しやキャンセル費用につながる。購入数や配送先の間違いも、文章の誤字と同じ感覚では直せない。こうした仕事は減点型として捉えられる。
パーソナルAIは、まさにこの面倒な手続きを引き受けることで便利さを伝えやすい。しかし、任せたい仕事ほど失敗の損失が大きいという難しさがある。途中まで順調に進んだデモだけでは、実際に任せられるかは分からない。
見るべきなのは、間違いそうなときに止まれるか、確認すべき条件を本人へ聞けるか、失敗を発見して報告できるかという振る舞いである。OpenAIの公式説明も、作業の処理が終わったことと、依頼した結果が達成されたことを区別している。予約なら確定内容、購入なら注文結果まで確認する必要がある。MetaもMuseについて、購入やメール送信の前に本人の承認を求めると説明する。こうした確認は、実用化の中心にある。
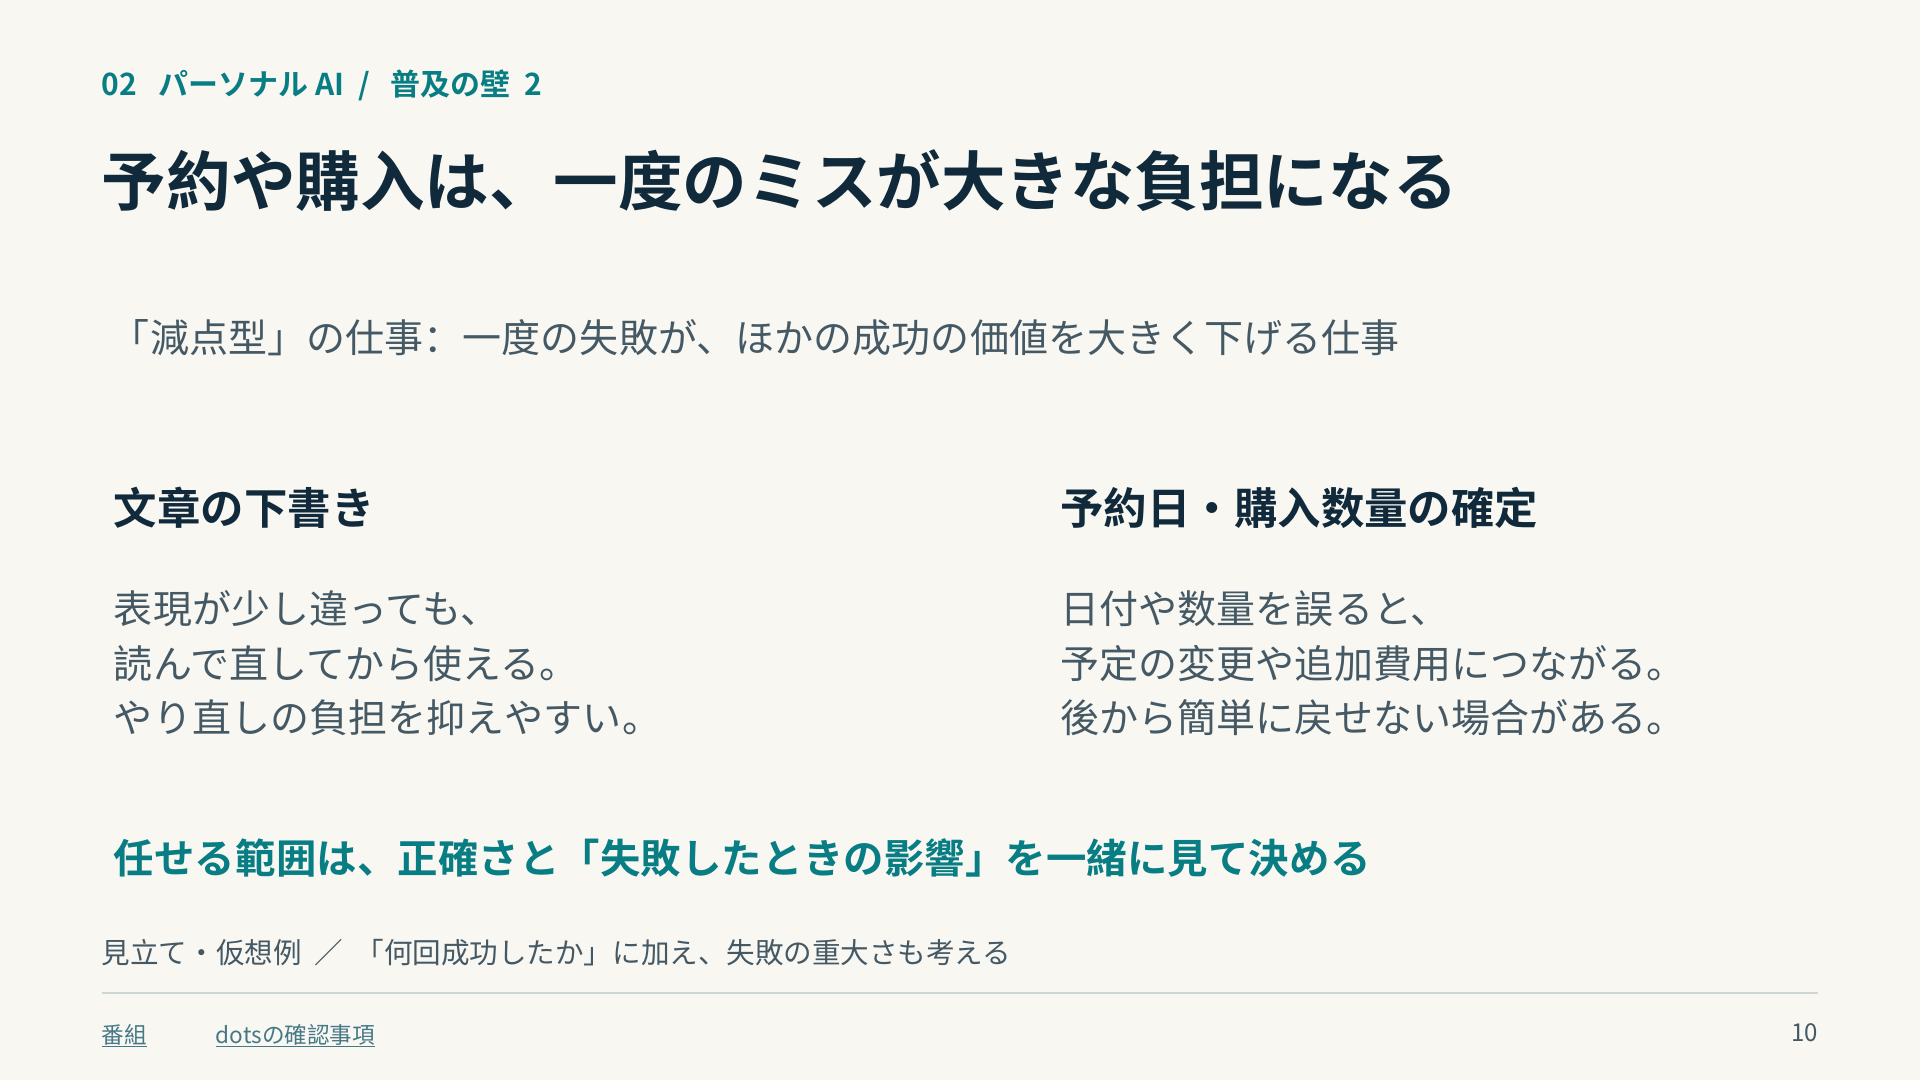
出典:番組33分22秒以降、dotsの作業と記憶、Muse公式発表。予約と購入の失敗例は本稿による説明用の仮例。
第三の壁は相手のサービスが利用を認めるか
AIに操作能力があっても、外部のサービスを自由に使えるとは限らない。今井氏の第三の懸念は、便利なサービスを持つ企業が自社のAIを育てる一方、他社のAIによるアクセスを制限すると、利用者の依頼がサービスの境界で止まってしまうことだ。
具体例として、GeekWireはAmazonがMuseによるAmazon.comでの代理購入を遮断したと報じた。同紙の取材に対し、Amazon側は事前合意、エージェントの自己識別、顧客情報の安全性を問題として挙げている。これは、あらゆる他社AIが一律に拒否されることを示す話ではない。また、競争相手を排除することだけが目的だと断定もできない。
それでも、利用者から見れば大きな制約になる。「この商品を条件に合う店で買って」と頼んでも、AIが調べられる店や手続きできる店が限られるなら、その範囲を知らなければ比較結果を過信してしまう。dotsの公式ガイドにも、一部のサイトがクラウドブラウザを遮断するという説明がある。
今後は、AIの操作能力に加え、サービス同士がどう接続し、誰の許可で、どこまでの情報を渡すかが使い勝手を左右する。利用者の代理として動くAIにも、受け入れるサイトにも、本人の意図と権限を確かめられる仕組みが求められる。
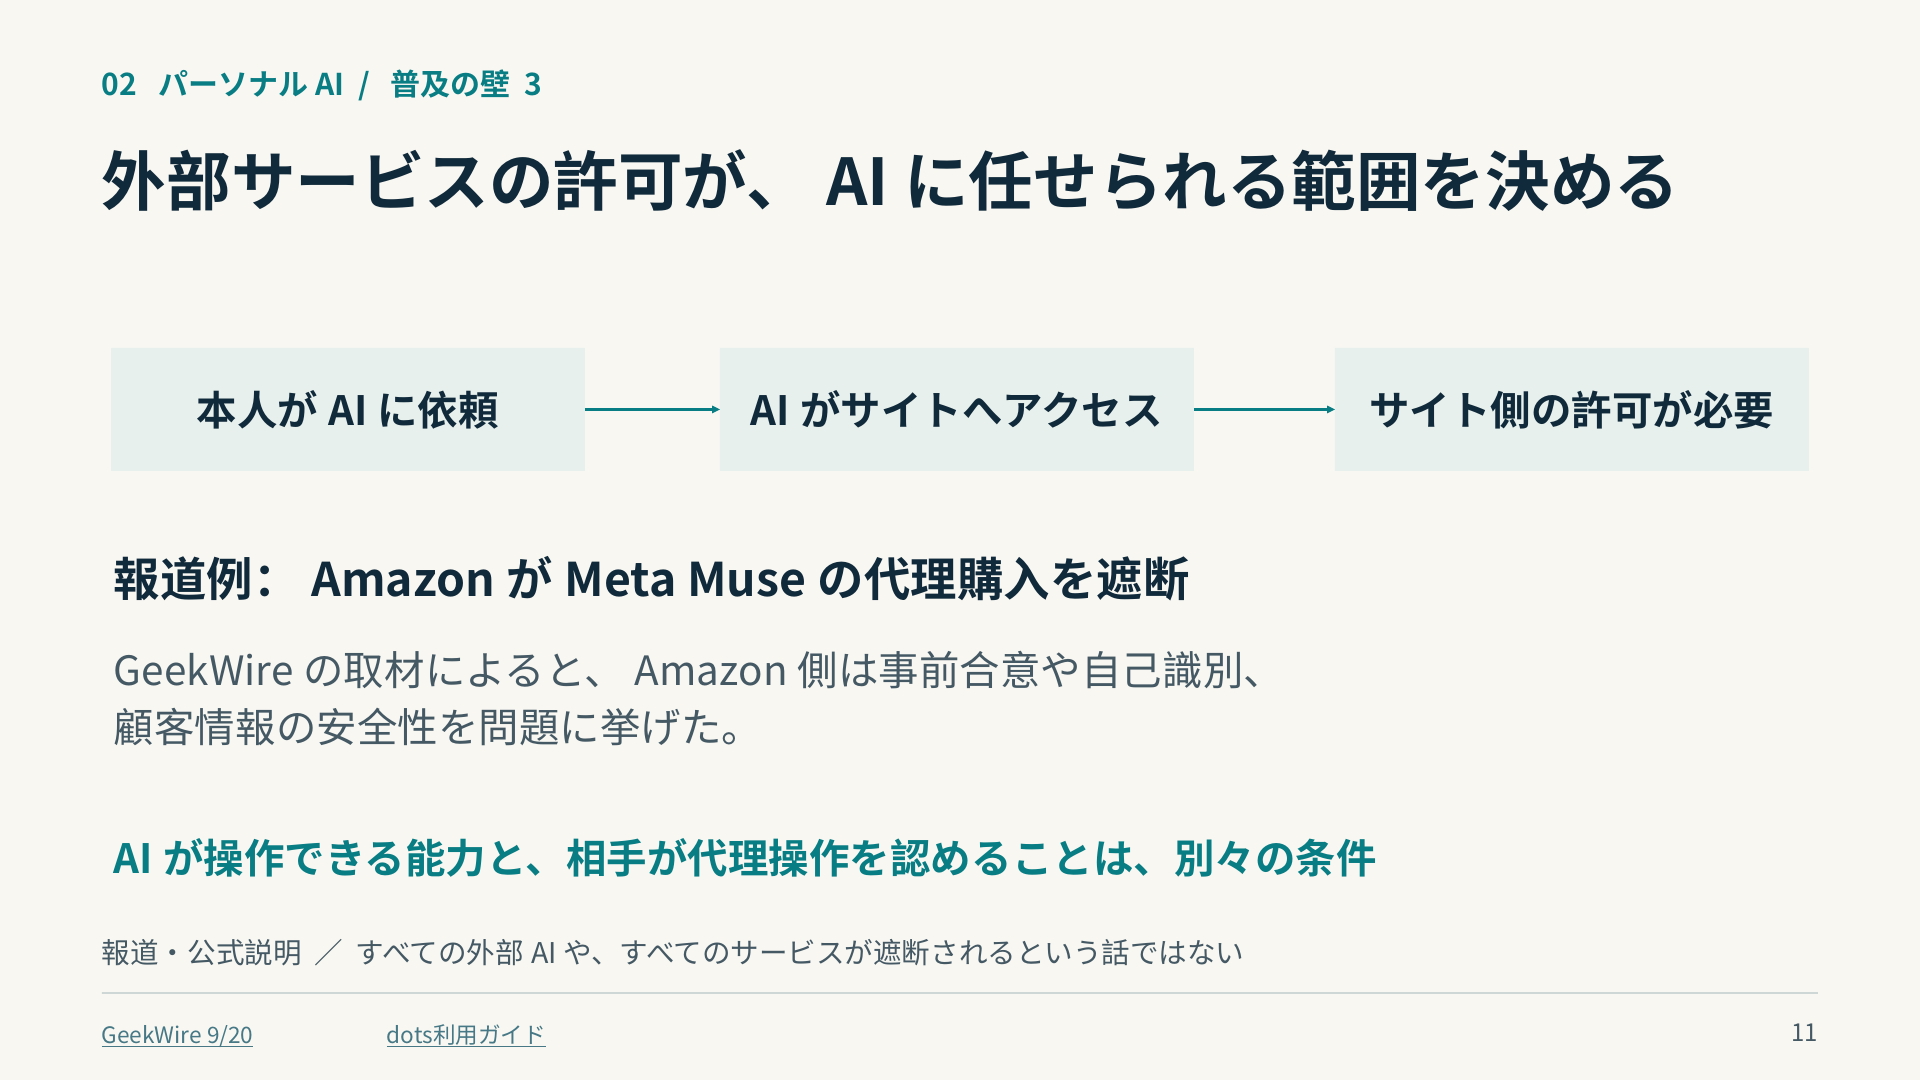
出典:GeekWireの報道、dots公式ガイド。サービスの分断に関する今井氏の懸念は番組35分59秒以降。
これからのAIは任せた仕事の結果まで見る
Gemini 4 Argonの登場は、GoogleをAI競争の有力な一社として評価する材料を増やした。同時に、総合点、正答率、幻覚率はそれぞれ異なる能力を示す。自分の仕事に必要な性能を見極める姿勢は、これまで以上に重要になる。
dotsやMuseが進む方向には、毎回説明しなくても自分の事情が伝わり、相談した後も仕事が進むという魅力がある。その価値を確かめるには、数週間使った後に説明や確認の手間が減ったか、許可の範囲を守ったか、実際に望んだ結果まで届いたかを見る必要がある。
利用する側は、まず調査、比較、下書きなど結果を確かめやすい仕事で相性を見るとよい。予約や購入を任せる場面では、日付、金額、相手先、取り消し条件など、間違えれば損失になる点を確認する。AIの進歩を評価する基準は、こうした具体的な仕事の中にある。
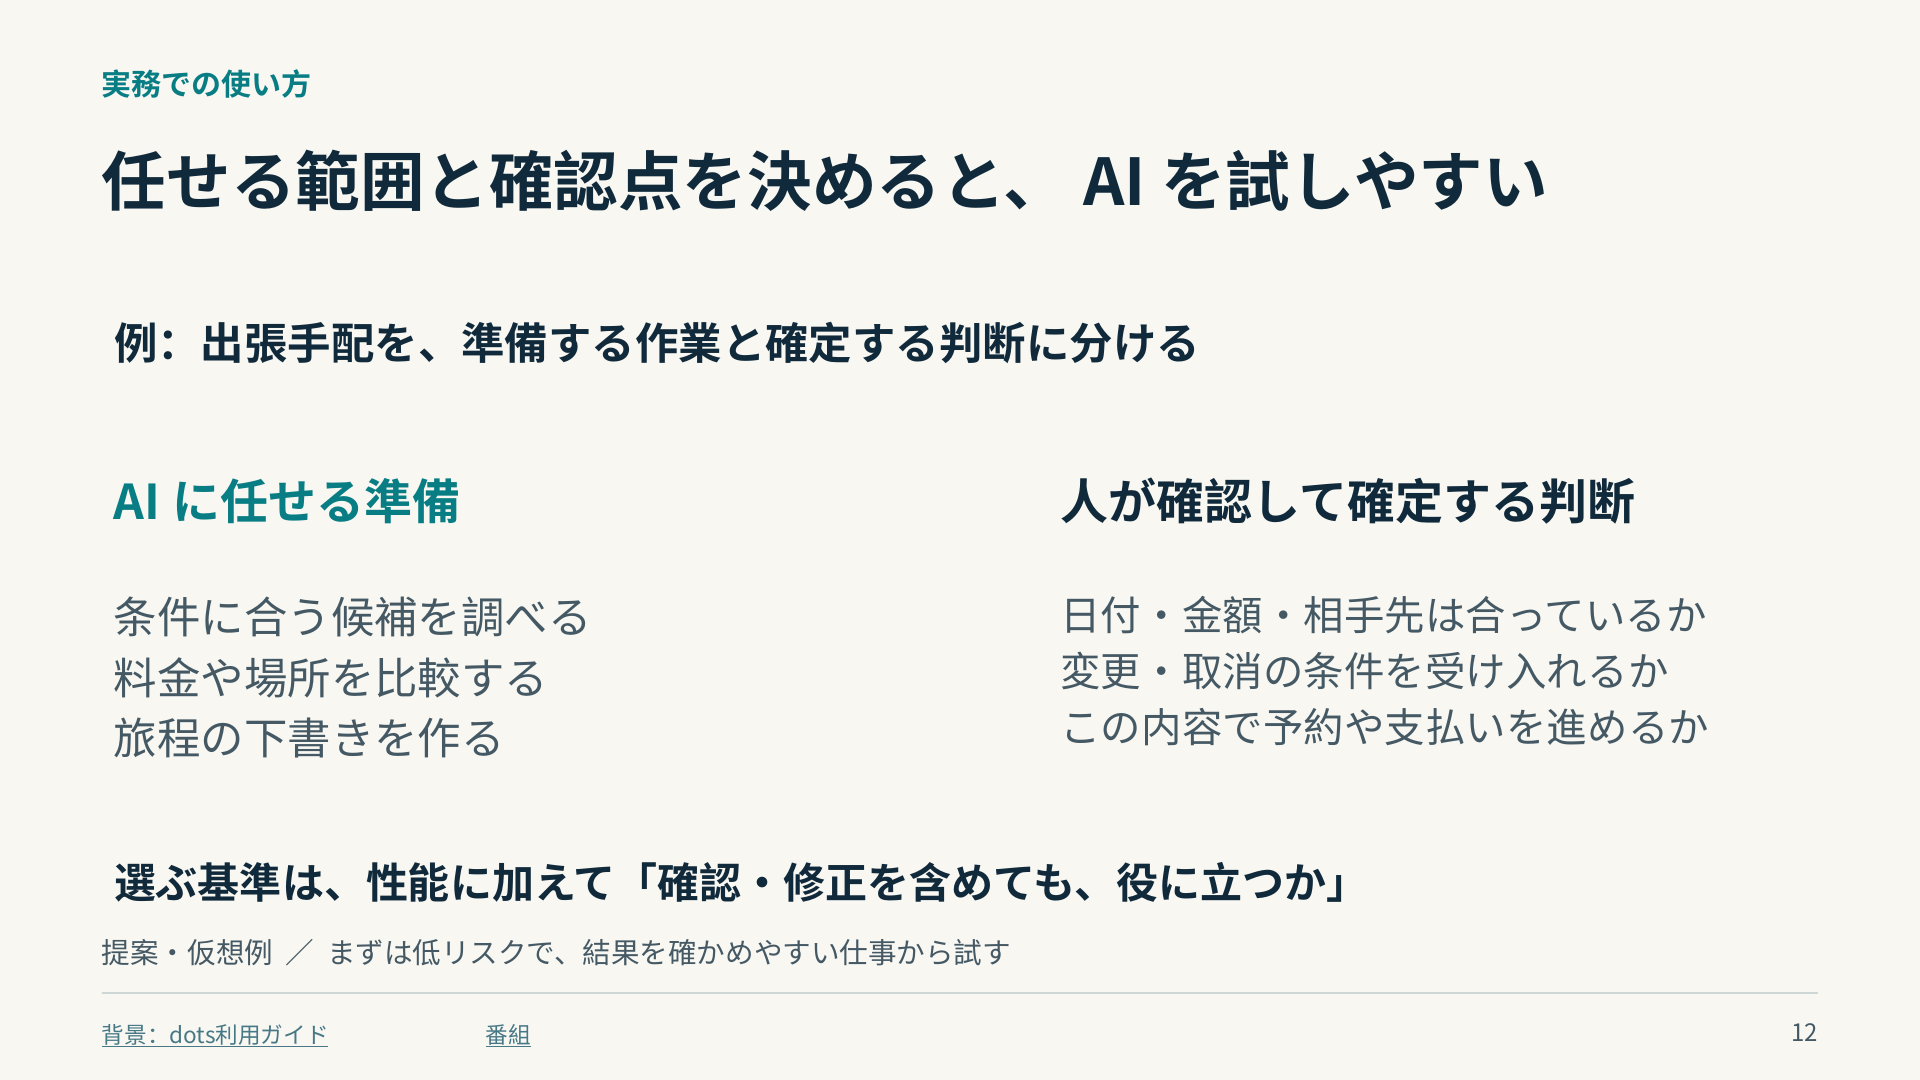
※製品の提供範囲、評価結果、公式説明は2026年10月3日時点。番組内で語られた未発表モデル、学習方法、価格から推定するモデル規模については、確認された事実として扱っていない。
制作に生成AIを使用しています。